

Qual provedor brasileiro tem GPU H200 disponível para locação?

Escrito por
Redação EVEO
Conteúdos produzidos por especialistas da EVEO, com experiência em infraestrutura de TI, servidores dedicados, private cloud, GPUs e soluções para ambientes de alta performance. Desde 2014, a empresa oferece soluções de infraestrutura para empresas no Brasil e no exterior.
EM RESUMO
A NVIDIA H200 e a GPU mais avançada para cargas de IA generativa, com 141 GB de memória HBM3e e bandwidth de 4,8 TB/s. No Brasil, a disponibilidade para locação ainda e restrita a poucos provedores de infraestrutura enterprise, dada a alta demanda global e a priorização de grandes hyperscalers internacionais no recebimento dos primeiros lotes.
- A H200 oferece até 90% mais performance em inferência de LLMs comparada à H100, graças à memória HBM3e de maior capacidade e bandwidth.
- A locação de GPU H200 no Brasil exige Data Center com capacidade de refrigeração avançada e energia dedicada: nem toda instalação Tier III suporta o thermal design power (TDP) de 700W por acelerador.
- Empresas que não encontram H200 disponível imediatamente podem optar pela H100 ou A100 em clusters multi-GPU, mantendo a capacidade de rodar modelos de grande porte com performance enterprise.
Este artigo e para você se:
- Você lidera um time de IA ou ML e precisa de GPU de última geração para treinamento ou inferência de grandes modelos de linguagem no Brasil;
- Está avaliando provedores de infraestrutura GPU e quer entender quem realmente tem H200 disponível para locação versus quem anuncia sem estoque real;
- Precisa dimensionar entre a H200 e alternativas como H100 ou A100, considerando custo-benefício e disponibilidade imediata no mercado nacional.
Neste artigo:
- O que e a GPU NVIDIA H200 e por que ela e diferente
- Quais as especificações técnicas da H200
- Quem tem GPU H200 para locação no Brasil
- H200 versus H100: quando vale a pena fazer o upgrade
- Qual infraestrutura é necessária para hospedar H200
- Comparativo: H200, H100, A100 e L40S para IA
- A abordagem da EVEO
- Perguntas frequentes
O que e a GPU NVIDIA H200 e por que ela e diferente
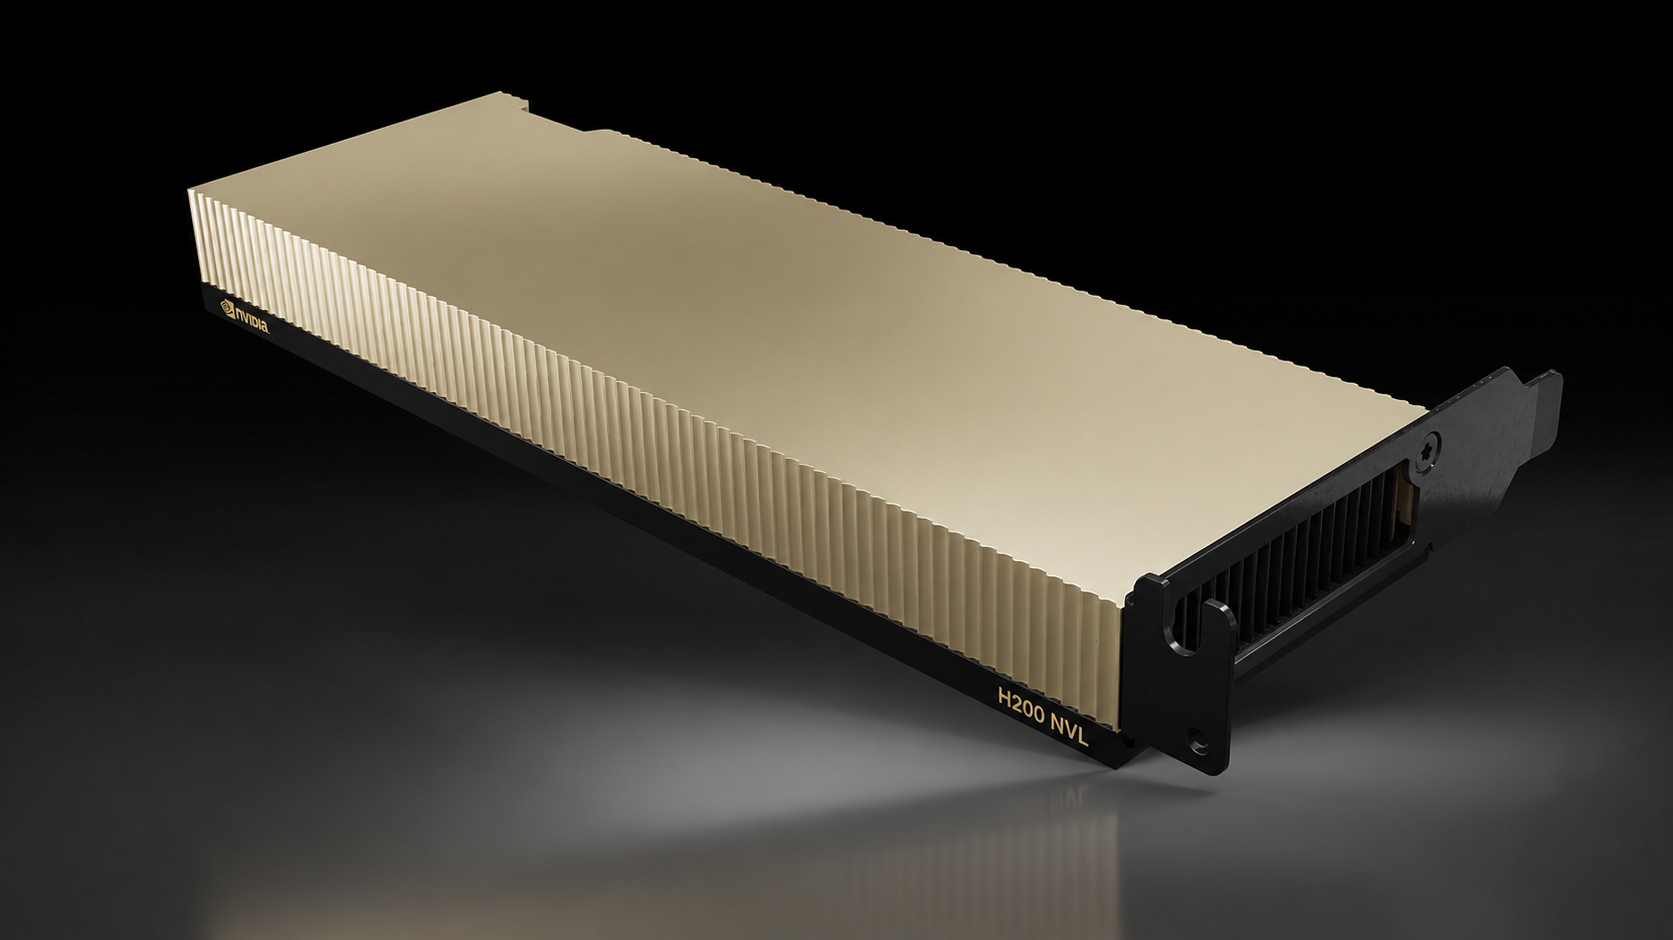
NVIDIA H200 e uma unidade de processamento gráfico (GPU) de Data Center da arquitetura Hopper, projetada exclusivamente para cargas de inteligência artificial de alta intensidade computacional. Lançada como evolução da H100, a H200 mantém a mesma quantidade de CUDA cores e Tensor Cores do modelo anterior, mas introduz memória HBM3e de 141 GB com bandwidth de 4,8 TB/s, o que a torna ideal para inferência de grandes modelos de linguagem (LLMs) e treinamento de modelos com bilhões de parâmetros.
A diferença fundamental da H200 não esta no poder de processamento bruto, mas na capacidade de mover dados. Em cargas de IA generativa, o gargalo frequentemente não e a capacidade de calcular, mas a quantidade de memória disponível para armazenar os pesos do modelo e os estados de atenção (KV cache) durante a inferência. Com 141 GB de VRAM, a H200 consegue rodar modelos significativamente maiores em precisão FP16 sem necessidade de quantização agressiva ou sharding entre múltiplas GPUs.
Outro ponto crucial: a H200 e otimizada para inferência em batch. Quando varias requisições são processadas simultaneamente, a maior capacidade de memoria permite manter mais sequencias ativas ao mesmo tempo, aumentando o throughput total do sistema. Para empresas que oferecem APIs de IA internas ou atendem múltiplos usuários simultâneos, isso se traduz diretamente em menor custo por token gerado.
Quais as especificações técnicas da H200
A NVIDIA H200 segue o formato SXM5, o mesmo da H100, o que facilita a atualização em servidores já compatíveis com a geração anterior. No entanto, a refrigeração e o consumo energético exigem atenção especial no momento do deploy.
| Especificacao | NVIDIA H200 | NVIDIA H100 SXM5 |
|---|---|---|
| Arquitetura | Hopper | Hopper |
| Memória VRAM | 141 GB HBM3e | 80 GB HBM3 / 80 GB HBM2e |
| Memory Bandwidth | 4,8 TB/s | 3,35 TB/s |
| Formato | SXM5 / PCIe | SXM5 / PCIe |
| TDP (consumo térmico) | Até 700W | Até 700W |
| NVLink | Sim, até 900 GB/s | Sim, até 900 GB/s |
| Transformers Engine | Sim (FP8, FP16) | Sim (FP8, FP16) |
O dado que mais chama atenção e o aumento de 76% no memory bandwidth em relação a H100. Isso significa que, para cargas bound by memory (limitadas por memoria), como inferência de LLMs com contexto longo, a H200 entrega ganhos significativos sem aumentar o consumo energético por acelerador.
Quem tem GPU H200 para locação no Brasil
O mercado brasileiro de locação de GPU de ultima geração ainda esta em fase de maturação. A NVIDIA prioriza a distribuição das primeiras unidades de H200 para grandes hyperscalers internacionais (AWS, Google Cloud, Microsoft Azure) e para centros de supercomputação governamentais e acadêmicos. Isso significa que a chegada da H200 ao Brasil, via canais de distribuição autorizados, ocorre de forma gradual e em volumes menores.
Atualmente, os provedores que oferecem H200 para locação no Brasil se dividem em três categorias:
1. Nuvens publicas com região Brasil: hyperscalers internacionais com Data Centers em São Paulo podem anunciar a disponibilidade de instancias com H200, mas a alocação dessas maquinas e altamente competitiva. Empresas brasileiras frequentemente encontram listas de espera longas ou precisam comprometer volumes mínimos de consumo para garantir acesso. Além disso, o modelo de negocio desses provedores envolve egress fees significativos e cobrança em dólar, o que dificulta o planejamento financeiro.
2. Provedores nacionais de infraestrutura bare metal: empresas como a EVEO, que operam Data Centers Tier III no território nacional, trabalham com a locação de servidores GPU dedicados. A oferta de GPUs enterprise no Brasil por provedores nacionais foca em modelos consolidados como NVIDIA A100, H100 e L40S, que já possuem estoque operacional e suporte técnico local estabelecido. A H200, por ser lançamento recente, entra nesse portfolio de forma gradual, conforme a demanda dos clientes corporativos justifica o investimento de importação e homologação.
3. Laboratórios de IA e parcerias acadêmicas: algumas universidades e centros de pesquisa no Brasil recebem GPUs de ultima geração via programas da NVIDIA ou parcerias governamentais, mas esses recursos não são disponibilizados para locação comercial.
H200 versus H100: quando vale a pena fazer o upgrade
A decisão entre locar H200 ou H100 depende exclusivamente do perfil da carga de trabalho. Para treinamento from scratch de grandes modelos (pré-training), a H200 oferece ganho modesto em relação a H100, já que ambas possuem a mesma capacidade de compute. Nesse cenário, montar um cluster de múltiplas H100 costuma ser mais econômico e imediatamente disponível.
Já para inferência de LLMs em produção, especialmente modelos acima de 70B parâmetros com contexto longo, a H200 se destaca. A capacidade de carregar modelos maiores em memoria reduz a necessidade de técnicas de paralelismo de modelo (model parallelism), que introduzem latência de comunicação entre GPUs. Isso se traduz em:
- Menor latência por token em modelos grandes
- Maior throughput de requisições simultâneas (batch size maior)
- Menor complexidade de deploy (uma única GPU ao invés de cluster multi-GPU)
- Possibilidade de rodar modelos de 405B parâmetros em quantização INT8 em configurações de 2-4 GPUs, ao invés de 8 ou mais
Para fine-tuning com técnicas como LoRA ou QLoRA, a H200 também oferece vantagem: a maior memoria permite trabalhar com ranks maiores ou datasets maiores sem estourar a VRAM. Isso e especialmente relevante para empresas que customizam modelos open source com dados proprietários.
Qual infraestrutura e necessária para hospedar H200
A H200 não e uma GPU que se instala em qualquer servidor. O formato SXM5 exige chassis específicos, como o NVIDIA HGX H200, que acomoda ate 8 GPUs interconectadas via NVLink e NVSwitch. Esses servidores são equipamentos enterprise de alto custo, com requisitos rigorosos de energia e refrigeração.
Energia: cada acelerador H200 consome ate 700W. Um servidor com 8 GPUs pode demandar mais de 10 kW por rack, considerando CPUs, memoria RAM, storage e overhead do sistema. Data Centers comerciais comuns nao conseguem suprir essa densidade de potencia por rack.
Refrigeracao: o calor gerado por 8 H200s em operação plena exige refrigeração liquida (liquid cooling) ou pelo menos sistemas de ar forçado de alta capacidade com hot aisle containment. Dimensionar um servidor corporativo para GPU de ultima geração exige avaliação térmica do Data Center, não apenas do servidor.
Rede: para treinamento distribuído em múltiplos nos, a rede entre servidores e crítica. InfiniBand NDR (400 Gb/s) e o padrão recomendado para clusters de IA. Rede Ethernet de 10 Gbps ou 25 Gbps e insuficiente para sincronização eficiente de gradientes em treinamento multi-node.
Storage: os datasets de treinamento e os checkpoints de modelos ocupam terabytes. SSD NVMe com leitura sequencial acima de 7 GB/s e praticamente obrigatório para alimentar as GPUs sem gargalos de I/O. A métrica de IOPS e latência que mais importa aqui e o throughput sequencial de leitura.
Comparativo: H200, H100, A100 e L40S para IA
| Critério | NVIDIA H200 | NVIDIA H100 | NVIDIA A100 | NVIDIA L40S |
|---|---|---|---|---|
| VRAM | 141 GB | 80 GB | 80 GB | 48 GB |
| Memory Bandwidth | 4,8 TB/s | 3,35 TB/s | 2 TB/s | 864 GB/s |
| Tensor Cores | 4ª geração | 4ª geração | 3ª geração | 4ª geração |
| Ideal para | Inferência LLM grande, contexto longo | Treinamento + inferência enterprise | Treinamento, inferência, HPC | Inferência, fine-tuning médio, gráficos |
| Disponibilidade no Brasil | Limitada, lista de espera | Boa em provedores enterprise | Ampla, estoque consolidado | Boa, custo-benefício para inferência |
| Custo de locação | Premium (alta demanda global) | Alto, mas estabilizado | Moderado, melhor custo por GB | Acessível para cargas de inferência |
A escolha da GPU correta e um exercício de balanceamento entre performance necessária, disponibilidade imediata e orçamento. Para a maioria das empresas brasileiras iniciando projetos de IA em 2026, a A100 ou H100 ainda oferecem o melhor custo-benefício. A H200 se justifica para casos de uso específicos onde a memoria extra gera economia proporcional na infraestrutura total.
A abordagem da EVEO
A EVEO, com mais de 10 anos de mercado, 5.000 clientes e 130 colaboradores, oferece infraestrutura de GPU para inteligência artificial em Data Centers Tier III localizados em Cotia/SP, Osasco/SP, Curitiba/PR, Fortaleza/CE e Miami/FL. Todos os ambientes são operados mediante CNPJ, com foco corporativo e sem atendimento a pessoa física.
O portfolio de GPU da EVEO inclui servidores bare metal e ambientes de nuvem privada equipados com NVIDIA A100, H100 e L40S, homologados para cargas de treinamento, fine-tuning e inferência de modelos de grande porte. A equipe de engenharia auxilia no dimensionamento correto de VRAM, storage e rede, considerando o modelo de IA e o volume de dados que a empresa pretende processar.
A EVEO não cobra egress fee. O custo e previsível em reais, o que permite que times de IA façam budget sem surpresas de fatura. A soberania de dados e garantida por contrato: os dados permanecem em território nacional, sob controle do cliente, com possibilidade de auditoria física e logica. Para organizações que lidam com dados sensíveis, essa conformidade com a LGPD e um diferencial critico.
Se você esta avaliando a locação de GPU H200 ou busca alternativas enterprise com disponibilidade imediata no Brasil, a EVEO oferece a arquitetura adequada para rodar seus workloads de IA com performance, segurança e custo controlado.
Perguntas frequentes
1. Qual a diferença entre a NVIDIA H200 e a H100?
A H200 e a evolução da H100 na arquitetura Hopper. Ambas possuem a mesma quantidade de CUDA cores e Tensor Cores, mas a H200 traz memoria HBM3e de 141 GB com bandwidth de 4,8 TB/s, contra 80 GB e 3,35 TB/s da H100. Isso representa um ganho de ate 90% em performance de inferência para grandes modelos de linguagem, especialmente em cenários com contexto longo ou batch processing. Para treinamento from scratch, o ganho e mais modesto.
2. Quanto custa locar uma GPU H200 no Brasil?
O custo de locação de H200 no Brasil e premium, refletindo a alta demanda global e a escassez de estoque. Preços podem variar significativamente conforme o provedor, o prazo de compromisso e o volume de GPUs. Hyperscalers internacionais cobram em dólar e adicionam egress fees, enquanto provedores nacionais de bare metal tendem a oferecer preciso em reais com maior previsibilidade. Para orçamentos precisos, e necessário solicitar cotação diretamente, já que a disponibilidade e dinâmica.
3. Posso usar H200 para treinamento de modelos do zero?
Sim, a H200 e totalmente capaz de treinar modelos do zero (pré-training). No entanto, o ganho em relação a H100 para essa tarefa e modesto, já que ambas compartilham a mesma capacidade de processamento. A vantagem da H200 se concentra em inferência e fine-tuning, onde a maior memoria permite trabalhar com modelos maiores, contextos mais longos e batches maiores. Para treinamento, um cluster de H100s costuma ser mais econômico e imediatamente disponível.
4. Preciso de refrigeração liquida para usar H200?
Não é obrigatório, mas e altamente recomendado para servidores com múltiplas H200s. Cada acelerador consome ate 700W, e um chassis com 8 GPUs pode gerar mais de 5.000W de calor apenas nas GPUs. Data Centers comerciais com ar condicionado padrão frequentemente nao conseguem dissipar essa carga térmica por rack. Provedores enterprise com certificação Tier III investem em refrigeração avançada (liquida ou ar forçado de alta capacidade) para suportar essa densidade.
5. Qual a melhor alternativa a H200 se ela não estiver disponível?
A melhor alternativa depende do caso de uso. Para inferência de LLMs grandes, uma H100 80GB oferece 70-80% da performance da H200 em muitos cenários. Para cargas menos intensivas, a L40S (48 GB) e uma opção de custo-benefício excelente. Para treinamento distribuído, um cluster de A100 80GBs ainda e uma arquitetura madura e amplamente suportada por frameworks como PyTorch e NVIDIA NeMo. A decisão deve considerar disponibilidade imediata, orçamento e o skill do time de MLOps.
6. A H200 é compatível com servidores que já rodam H100?
Sim, a H200 utiliza o mesmo formato SXM5 da H100 e e compatível com os chassis NVIDIA HGX H100. Isso significa que provedores que já possuem infraestrutura para H100 podem fazer upgrade para H200 sem trocar o servidor completo, desde que a refrigeração e a alimentação do rack suportem a carga. Essa compatibilidade retroativa facilita a evolução do parque de GPU sem obsolescência imediata do hardware de suporte.