

GPU Dedicada
GPU dedicada NVIDIA para rodar IA em Data Center no Brasil
Contrate as melhores GPUs do mundo como serviço (IaaS) e tenha uma infraestrutura robusta, garantindo operações de IA confiáveis, seguras e escaláveis.
100% da GPU dedicada ao seu workload, performance exclusiva sem dividir recursos.
Poder computacional, largura de banda e aceleração gráfica de alta performance sustentados pela maior empresa de Servidores Dedicados e Private Cloud do Brasil.


Milhares de núcleos em paralelo
CPUs processam tarefas em sequência, GPUs executam milhares de operações simultâneas, é isso que torna viável treinar modelos e rodar inferência em escala.
Escalável e 100% dedicado ao seu projeto
Com opções de 16GB (T10) a configurações de alta capacidade, você escolhe a VRAM pelo tamanho do seu modelo e roda LLMs sem fatiar o workload nem perder consistência.
Sua GPU nunca espera pelo dado
Integração com discos de altíssimo IOPS para garantir que o fluxo de dados alimente as GPUs continuamente, eliminando qualquer gargalo de leitura.
Por que escolher a
GPU Dedicada EVEO
Uma infraestrutura poderosa e totalmente isolada para que o seu negócio treine modelos e processe dados com segurança e estabilidade.
Infraestrutura de aceleração para operações que exigem previsibilidade.
Sem variação cambial, cobrança por hora ou surpresas na fatura: custo mensal fixo em reais com hardware 100% dedicado em Data Centers Tier III.
Liberdade para escolher as melhores GPUs do mercado.
Do VDI com T10 à inferência em escala com L4 e ao treinamento de LLMs em clusters HGX com B300, a EVEO dimensiona o modelo ideal para o seu projeto.
Seus dados seguros em infraestrutura no Brasil
Data Centers Tier III em território nacional, latência mínima e equipe técnica em português, 24x7. Tudo da maior operação de servidores dedicados do país.


Infraestrutura como serviço que prepara empresas para liderar o mercado com a gente.
Perguntas frequentes sobre
GPU Dedicada
O que é uma GPU e para que serve?

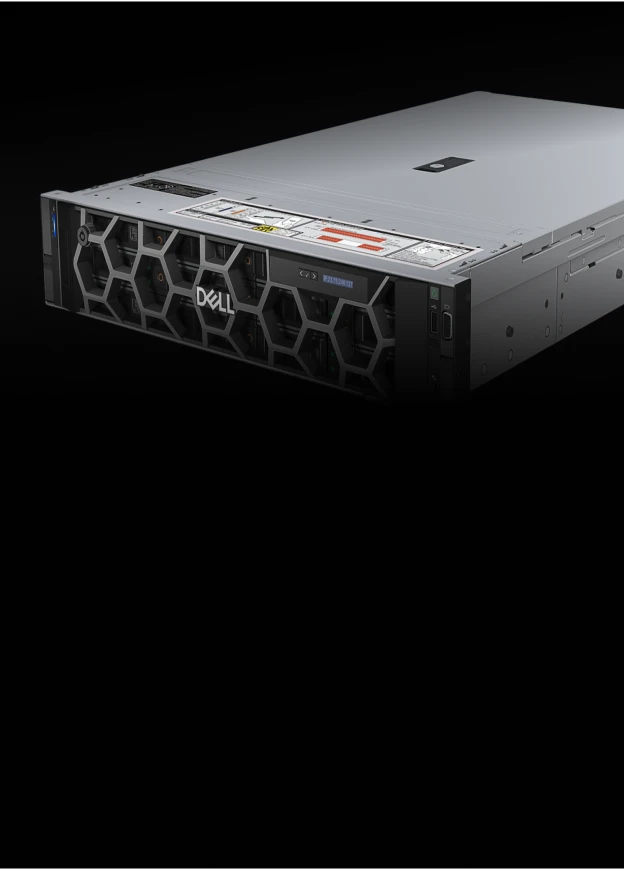
Um servidor com GPU é um servidor equipado com uma ou mais placas de vídeo para acelerar o processamento paralelo. Ele é usado para treinar e rodar modelos de inteligência artificial, fazer inferência de LLMs, renderização 3D, data analytics e VDI. Na GPU dedicada da EVEO, a placa de vídeo inteira fica reservada para a sua empresa, dentro de um servidor completo (CPU, memória e armazenamento NVMe).
Para quais projetos a GPU dedicada da EVEO é indicada?
A GPU dedicada da EVEO é indicada para empresas que rodam cargas de trabalho intensas e precisam de desempenho estável, sem disputar recursos com outros clientes. Os principais projetos são:
- Treinamento e operação de modelos de inteligência artificial e machine learning, inclusive inferência de LLMs.
- Data analytics e processamento de big data.
- Renderização 3D profissional e computação de alto desempenho (HPC).
- Virtualização de estações de trabalho de engenharia ou arquitetura (VDI).
GPU dedicada mensal ou GPU por hora na nuvem: qual compensa mais?
Nas nuvens públicas de hiperescala, os recursos gráficos geralmente operam sob demanda flutuante ou compartilhada, o que expõe sua operação à disputa de recursos com outros usuários e à instabilidade operacional. A EVEO elimina essa fricção entregando isolamento total. Sua empresa não sofre com variações de performance causadas por terceiros e conta com disponibilidade contínua para rodar modelos complexos sem interrupções ou sobressaltos de hardware. Além disso, substituímos as complexas calculadoras de tráfego por faturamento previsível corporativo.
Quanto custa um servidor com GPU dedicada?
Sua empresa recebe um modelo de faturamento estável e adequado à realidade orçamentária do mercado brasileiro. Diferente de provedores internacionais cobrados em moeda estrangeira e sujeitos a variações cambiais diárias, na EVEO os contratos possuem valores fixos em reais. Não cobramos taxas surpresa sobre a transferência ou tráfego de dados internos, o que permite previsibilidade real e segurança financeira para o planejamento do seu negócio.
O tráfego é ilimitado?
Sim. O tráfego é ilimitado, sem cobrança por volume transferido e sem taxa de saída de dados. A velocidade da porta de rede é definida conforme o plano contratado e confirmada na proposta.
Quais modelos de GPU NVIDIA estão disponíveis na infraestrutura?
Trabalhamos com um portfólio selecionado de hardware NVIDIA de última geração para atender diferentes estágios de maturidade tecnológica:
- NVIDIA Tesla T10: otimizada para virtualização gráfica robusta e infraestrutura de VDI estável.
- NVIDIA RTX PRO 4500 Server Edition: Desenvolvida para workloads profissionais de IA, computação gráfica e processamento de alto desempenho.
- NVIDIA RTX PRO 6000 Server Edition: ideal para IA avançada, computação gráfica e workloads de alto desempenho.
- NVIDIA H200: capacidade computacional de última geração, com alto volume de memória e throughput massivo para workloads sob extrema exigência.
- NVIDIA HGX B300: projetada para treinamento e inferência de IA em larga escala, com processamento de alto desempenho.
Qual a diferença entre GPU dedicada, compartilhada e integrada?
Em computadores pessoais, a placa de vídeo dedicada é a que tem chip e memória próprios, e a integrada fica dentro do processador e divide a memória do sistema. Em servidores, "dedicada" tem outro sentido: a GPU é exclusiva de um único cliente. Na GPU compartilhada, a placa é dividida entre vários usuários e o desempenho oscila conforme o uso dos outros. Na GPU dedicada da EVEO, núcleos, VRAM e banda são só da sua empresa, tornando toda a operação mais estável e previsível.
Qual a diferença entre CPU e GPU?
GPU (Graphics Processing Unit ou unidade de processamento gráfico) é o processador da placa de vídeo. A CPU tem poucos núcleos, otimizados para executar tarefas em sequência. A GPU tem milhares de núcleos que trabalham em paralelo, o que a torna muito mais rápida em cálculos massivos e repetitivos, como treinar modelos de IA, renderizar imagens 3D e processar grandes volumes de dados. Em um servidor com GPU, as duas trabalham juntas: a CPU coordena o sistema e a GPU acelera as cargas pesadas.
Qual é o SLA de disponibilidade da GPU Dedicada?
Posso usar mais de uma placa de vídeo no mesmo servidor?
Sim. A quantidade de placas depende do modelo escolhido e do chassi do servidor. Em configurações com várias GPUs, como H200 com NVLink e o cluster HGX com 8 GPUs B300, as placas se comunicam por NVLink, uma interconexão de alta velocidade feita para IA e diferente do SLI, que era voltado a jogos. A nossa equipe técnica dimensiona a configuração junto com o seu time.
Qual sistema operacional e quais drivers já vêm instalados?
A GPU serve para inferência ou só para treinamento?
Posso rodar LLMs open-source em ambiente privado?
Sim. Na EVEO, você hospeda modelos como Llama, DeepSeek, Qwen ou Mistral no seu próprio ambiente, sem enviar dados para APIs de terceiros. É uma opção para empresas que querem usar IA generativa com dados sensíveis, mantendo as informações no Brasil e sob controle da própria equipe.
Posso começar pequeno e aumentar a capacidade depois?
Como funciona o armazenamento de dados para treinamento de modelos?
O servidor de GPU pode ser combinado com armazenamento local em NVMe, para os dados que precisam de leitura rápida, e com o Object Storage da EVEO, para os volumes maiores de dataset. A arquitetura é definida junto com a sua equipe conforme o volume e a frequência de acesso.
Onde ficam os servidores com GPU da EVEO?
Os servidores com GPU ficam em Data Centers Tier III em São Paulo, Osasco, Curitiba, Fortaleza e Miami. Os dados de treinamento e inferência permanecem em território nacional, sob a legislação brasileira. Isso facilita a adequação à LGPD e reduz a latência para usuários no Brasil.
Em quanto tempo a GPU fica disponível depois da contratação?
Terei autonomia total sobre o ambiente? Como funciona a instalação de drivers e frameworks (como CUDA, PyTorch ou TensorFlow)?