

Melhor empresa para alugar GPU para inferência de LLM


EM RESUMO
Escolher uma empresa de GPU para inferência de LLM exige avaliar memória de vídeo, desempenho sob carga, latência, disponibilidade, custos e tratamento de dados. A GPU dedicada oferece recursos exclusivos e maior controle da operação, mas o dimensionamento depende do modelo, da concorrência de requisições e dos objetivos da aplicação.
- Compare VRAM, largura de banda e suporte a múltiplas GPUs.
- Meça TTFT, TPOT e throughput em testes com a carga real.
- Considere custos de infraestrutura, transferência e operação.
Este artigo é para você se:
- Precisa colocar um LLM em produção com desempenho previsível.
- Está comparando GPU dedicada e compartilhada.
- Quer avaliar provedores, custos e requisitos de LGPD para IA.
Neste artigo:
O que é inferência de LLM e por que exige GPU?
Inferência de LLM é a execução de um modelo de linguagem já treinado para processar solicitações e gerar respostas. O desempenho depende do tamanho do modelo, da quantidade de usuários simultâneos, da extensão dos prompts e da infraestrutura utilizada.
LLMs têm bilhões de parâmetros. A GPU acelera as operações matriciais necessárias para processá-los e oferece memória de alta largura de banda. CPUs também podem executar modelos, especialmente os menores ou quantizados, mas GPUs costumam ser mais adequadas para aplicações com alta demanda de inferência.
Em produção, três fatores são decisivos: capacidade de VRAM para acomodar pesos e cache de atenção, largura de banda para movimentar dados e capacidade de processamento para atender requisições concorrentes.
Quais critérios avaliar ao escolher uma empresa de GPU para LLM?
A escolha do provedor deve considerar a carga real da aplicação e não apenas o preço anunciado.
1. Modelo de GPU disponível
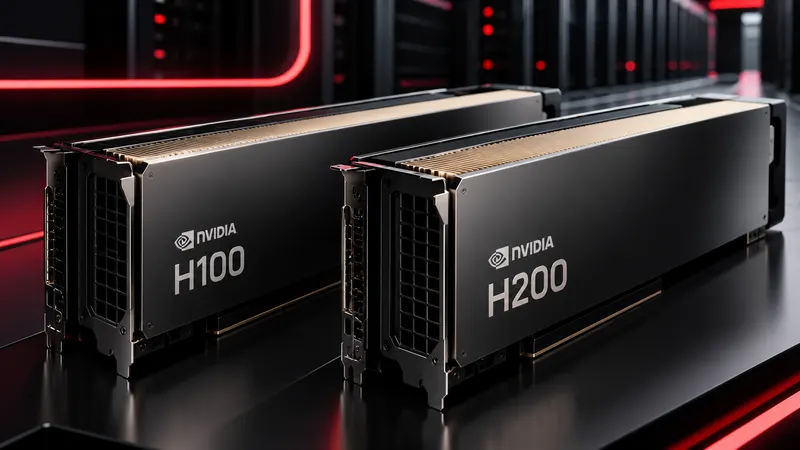
Verifique memória, largura de banda, suporte a precisão reduzida e possibilidade de usar múltiplas GPUs. Entre as opções do portfólio EVEO informado estão NVIDIA T10 16 GB, RTX PRO 4500 SE 32 GB, RTX PRO 6000 SE 96 GB, H200 141 GB, H200 NVLink e HGX B300. A configuração adequada depende do modelo de IA e da concorrência esperada.
Consulte também o guia sobre o que considerar ao escolher um servidor GPU para empresas.
2. Latência consistente
Meça o tempo até o primeiro token (TTFT), o tempo por token de saída (TPOT) e a variação dessas métricas sob carga. Infraestrutura dedicada reduz a disputa com outros clientes pelos recursos físicos, mas não elimina variações causadas pela própria aplicação.
3. Disponibilidade e SLA
Confira o SLA contratual, os mecanismos de redundância, a conectividade e os procedimentos de manutenção. A EVEO informa SLA de 99,5% para os serviços aplicáveis; confirme as condições específicas da proposta.
4. LGPD e localização dos dados
Se prompts, respostas ou bases de conhecimento contiverem dados pessoais, avalie contratos, medidas de segurança, subprocessadores e eventuais transferências internacionais. Hospedar no Brasil pode facilitar o controle, mas não garante conformidade automática com a LGPD.
5. Previsibilidade de custos
Considere preço mensal, tráfego de saída, armazenamento, rede, suporte e eventuais serviços adicionais. A cobrança em reais e a ausência de egress fee da EVEO ajudam no planejamento financeiro.
6. Suporte técnico
Verifique o escopo do suporte contratado e a experiência necessária para operar a aplicação. Frameworks como vLLM, TensorRT-LLM e TGI podem exigir otimizações de memória, batching e observabilidade.
7. Capacidade de expansão
Analise como aumentar a quantidade de GPUs e distribuir modelos maiores com técnicas como tensor parallelism, considerando conectividade entre placas e custo total.
GPU dedicada ou compartilhada: qual é melhor para inferência de LLM?
Na GPU dedicada, os recursos físicos contratados ficam disponíveis para a aplicação. Em modalidades compartilhadas, a alocação e o isolamento dependem da tecnologia e do contrato. Ambas podem funcionar em produção; a decisão deve considerar custo, desempenho e previsibilidade.
| Aspecto | GPU dedicada | GPU compartilhada |
|---|---|---|
| Recursos | Capacidade contratada exclusiva | Capacidade alocada conforme o serviço |
| VRAM | Disponível conforme a configuração contratada | Limitada à partição ou cota contratada |
| Latência | Maior controle sobre a carga | Pode variar conforme a modalidade de compartilhamento |
| Escalabilidade | Expansão por novas GPUs ou servidores | Depende das opções do provedor |
| Custo | Geralmente fixo por período | Pode ser menor em uso intermitente |
Latência e tokens por segundo: o que importa para LLM?
TTFT (Time to First Token)
É o intervalo entre o envio da solicitação e a geração do primeiro token. É influenciado pelo tamanho do prompt, pelo processamento inicial (prefill), pela fila de requisições e pela infraestrutura.
TPOT (Time per Output Token)
É o tempo médio entre tokens sucessivos da resposta. Ajuda a avaliar a fluidez do texto gerado em streaming.
Throughput e percentis
Tokens por segundo e requisições por segundo indicam capacidade de atendimento. Para avaliar consistência, acompanhe também TTFT e TPOT nos percentis P95 e P99, além das médias.
Como a conformidade com a LGPD afeta a escolha de GPU para LLM?
Prompts e respostas podem conter dados pessoais, informações financeiras ou documentos confidenciais. A empresa deve avaliar como esses dados são coletados, transmitidos, armazenados, processados e eliminados.
A LGPD não exige, de forma geral, que todos os dados pessoais sejam armazenados e processados exclusivamente no Brasil. Transferências internacionais podem ocorrer nas hipóteses previstas em lei e na regulamentação aplicável.
Ao contratar infraestrutura, verifique cláusulas de tratamento de dados, controles de acesso, registros, políticas de retenção e medidas de segurança. A escolha de um data center brasileiro pode apoiar uma estratégia de residência de dados, mas não substitui a governança da aplicação.
Qual é o custo total de GPU para inferência de LLM?
O custo total inclui mais que a GPU. Considere os componentes abaixo e compare propostas equivalentes em capacidade, tempo de uso e nível de serviço.
- Locação da GPU e demais recursos do servidor.
- Armazenamento dos modelos, logs e bases de conhecimento.
- Tráfego de rede e eventuais cobranças de saída de dados.
- Monitoramento, suporte e operação da aplicação.
- Capacidade ociosa e custos de expansão.
Exemplo de dimensionamento
Uma empresa que executa um modelo de 7 bilhões de parâmetros continuamente deve estimar a quantidade de requisições simultâneas, o tamanho médio dos prompts e o volume de tokens gerados. A partir desses dados, é possível testar uma GPU adequada e calcular o custo por milhão de tokens ou por requisição atendida.
Não é possível afirmar uma economia percentual fixa frente à nuvem pública sem comparar propostas e medições equivalentes. Os valores mensais da EVEO dependem da GPU e da configuração contratada.
Como comparar provedores de GPU para inferência de LLM?
| Critério | EVEO (GPU dedicada) | Nuvem pública |
|---|---|---|
| Modelo de contratação | Recursos dedicados conforme proposta | Instâncias dedicadas ou modalidades compartilhadas |
| Faturamento | Em reais | Depende do provedor e contrato |
| Egress fee | Sem cobrança de egress fee | Depende do serviço e da região |
| SLA | 99,5%, conforme condições contratuais | Varia por produto e arquitetura |
| Residência de dados | Possibilidade de contratação em data centers brasileiros | Depende da região e dos serviços utilizados |
| Suporte | Atendimento 24/7 em português | Depende do plano contratado |
A abordagem da EVEO para inferência de LLM
A EVEO oferece infraestrutura com GPU NVIDIA dedicada para projetos de IA, com faturamento em reais e atendimento consultivo para dimensionamento de recursos.
GPUs para diferentes cargas de inferência
O portfólio informado inclui NVIDIA T10 16 GB, RTX PRO 4500 SE 32 GB, RTX PRO 6000 SE 96 GB, H200 141 GB, configurações H200 NVLink e HGX B300. A escolha deve considerar VRAM, quantização, tamanho do contexto e número de usuários simultâneos. Consulte a disponibilidade comercial antes de publicar especificações ou preços.
Infraestrutura e suporte
A EVEO mantém operações em data centers em Cotia, Osasco, Curitiba, Fortaleza e Miami. As condições de localização, conectividade, suporte e SLA devem ser verificadas para cada contratação.
Previsibilidade financeira
O faturamento em reais e a ausência de egress fee ajudam a controlar despesas em aplicações que processam dados continuamente.
Portfólio complementar
Além de GPU dedicada, a EVEO oferece servidores dedicados, Private Cloud, colocation, armazenamento e soluções de continuidade. Conheça as opções de GPU dedicada da EVEO.
Dimensione a GPU para seu projeto de LLM
Converse com a equipe da EVEO sobre memória, processamento e capacidade para colocar sua aplicação de IA em produção.
Fale com um especialista da EVEO
Perguntas frequentes sobre GPU para inferência de LLM
O que é inferência de LLM e por que usar GPU?
Inferência é a execução de um modelo de linguagem treinado para responder a solicitações. GPUs aceleram operações matemáticas e oferecem memória de alta largura de banda, sendo especialmente úteis para modelos maiores e cargas com muitas requisições. Modelos menores também podem funcionar em CPU.
Quanto custa alugar GPU para inferência de LLM?
O valor depende do modelo de GPU, da memória, dos recursos do servidor e das condições comerciais. A EVEO oferece configurações com preços em reais; solicite uma proposta atualizada para comparar custos de infraestrutura dedicada e nuvem pública.
Qual é a diferença entre GPU dedicada e compartilhada para LLM?
GPU dedicada disponibiliza recursos físicos exclusivos conforme o contrato. Em GPU compartilhada, os recursos são divididos ou particionados entre usuários. A melhor opção depende da previsibilidade necessária, do volume de processamento e do orçamento.
Como a LGPD afeta a escolha de GPU para LLM?
Se o modelo processa dados pessoais, a empresa deve adotar medidas adequadas de segurança e tratamento de dados, além de avaliar contratos e transferências internacionais. Hospedar no Brasil pode facilitar a gestão da localização dos dados, mas não assegura conformidade automática.
Egress fee impacta o custo da inferência de LLM?
Pode impactar, dependendo do volume de dados transferidos para fora da infraestrutura e da política de cobrança do provedor. É importante distinguir tráfego de rede de quantidade de tokens: tokens gerados não equivalem diretamente a gigabytes faturáveis. A EVEO informa ausência de cobrança de egress fee.
A EVEO oferece GPU para inferência de LLM?
Sim. A EVEO oferece servidores com GPU NVIDIA dedicada para empresas, com suporte 24/7 em português, faturamento em reais e opções de infraestrutura no Brasil. A configuração indicada depende dos requisitos do modelo e da aplicação.
Escrito por
Redação EVEO
Conteúdos produzidos por especialistas da EVEO, com experiência em servidores dedicados, Private Cloud, GPUs e infraestrutura de TI. Desde 2014, oferecemos soluções para empresas que exigem alto desempenho, segurança e disponibilidade.