



Placa de vídeo para IA é a GPU usada para treinar e executar modelos de inteligência artificial. A escolha depende principalmente da memória de vídeo (VRAM), do volume de uso e de onde a placa vai rodar.
- Existem três categorias: placas de consumo (GeForce RTX), profissionais (RTX PRO) e de data center (de L4 a H200 e B200);
- A VRAM é o primeiro critério de escolha, porque define o tamanho do modelo que a placa consegue rodar;
- Uma RTX de consumo funciona bem para testes e protótipos, mas tem limites de memória, refrigeração e licenciamento em produção;
- Para IA em produção, as empresas costumam optar por GPUs profissionais ou de data center, compradas ou contratadas como GPU dedicada.
- Está escolhendo uma placa de vídeo para rodar IA na empresa;
- Começou com uma RTX de consumo e precisa decidir o próximo passo;
- Precisa justificar internamente a diferença entre uma placa gamer e uma GPU de data center.
Com a IA entrando na rotina das empresas, escolher a placa de vídeo certa virou uma decisão de infraestrutura, e não só de hardware.
Uma placa que funciona bem em testes pode não sustentar o mesmo modelo quando ele passa a atender usuários reais, 24 horas por dia.
Por isso, antes de comprar ou contratar uma GPU, é importante entender os tipos de placa disponíveis, quanta memória o seu modelo precisa e quais limites aparecem em produção.
O que é uma placa de vídeo para IA?
Placa de vídeo para IA é a GPU (unidade de processamento gráfico) usada para treinar e executar modelos de inteligência artificial. Ela substitui ou complementa o processador (CPU) nas tarefas que exigem muitos cálculos ao mesmo tempo.
A explicação está na arquitetura. Uma CPU tem poucos núcleos, otimizados para executar tarefas em sequência. Uma GPU tem milhares de núcleos menores, que fazem operações matemáticas em paralelo.
Modelos de IA são, essencialmente, grandes volumes de multiplicações de matrizes. Por isso, rodam muito mais rápido em GPU. As placas NVIDIA mais recentes ainda trazem núcleos dedicados a esse tipo de cálculo, os Tensor Cores.
Mas nem toda placa de vídeo serve para qualquer projeto de IA. A escolha depende do tamanho do modelo, do volume de uso e de onde a placa vai rodar.
Quais são os tipos de placa de vídeo para IA?
As placas de vídeo NVIDIA usadas em IA se dividem em três categorias, cada uma pensada para um tipo de uso.
Placas de consumo (GeForce RTX)
São as placas vendidas para jogos e criação de conteúdo, como a RTX 4090 e a RTX 5090. Têm bom poder de processamento e custo de entrada mais baixo, por isso são comuns em estações de desenvolvimento.
O limite está na memória (24 GB na RTX 4090 e 32 GB na RTX 5090), na refrigeração pensada para desktop e na licença dos drivers, que não prevê uso em data center.
Placas profissionais (RTX PRO)
São voltadas a estações de trabalho e servidores corporativos. A RTX PRO 6000 Blackwell, por exemplo, tem 96 GB de memória GDDR7 e versão própria para servidores.
Oferecem mais memória, drivers certificados e recursos corporativos, como a divisão da placa em instâncias isoladas (MIG). São uma opção comum para inferência de modelos médios e grandes.
Placas de data center (de L4 a B200)
São aceleradores feitos para operar em rack, 24 horas por dia. A linha vai de opções voltadas a inferência a aceleradores para treinamento em larga escala.
- Para inferência: a L4, com 24 GB, é compacta e de baixo consumo, e a L40S, com 48 GB, atende modelos maiores e cargas mistas de IA e gráficos;
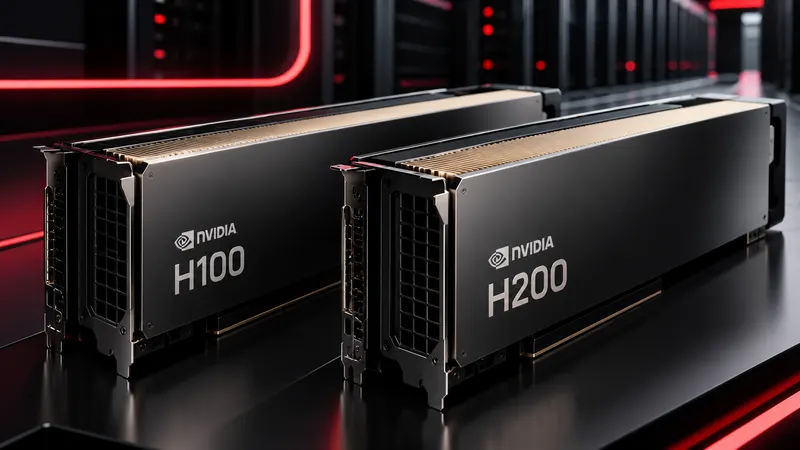
- Para LLMs grandes e treinamento: a H100 tem 80 GB, e a H200 tem 141 GB de memória HBM3e, com largura de banda de 4,8 TB/s;
- Geração Blackwell: a B200 chega a 192 GB de memória HBM3e e é voltada a treinamento e inferência dos maiores modelos.
As placas de topo podem ser interligadas por NVLink, o que permite dividir modelos grandes entre várias GPUs. São indicadas para treinamento, inferência de LLMs grandes e cargas com muitos usuários simultâneos. Para entender as diferenças entre gerações, veja a comparação entre NVIDIA H200 e H100.
Comparativo entre as categorias
| Critério | Consumo (GeForce RTX) | Profissional (RTX PRO) | Data center (L4 a B200) |
|---|---|---|---|
| Exemplos | RTX 4090, RTX 5090 | RTX PRO 6000 Blackwell | L4, L40S, H100, H200, B200 |
| Memória de vídeo | 24 a 32 GB | Até 96 GB | 24 a 192 GB |
| Refrigeração | Pensada para desktop | Versões para estação e servidor | Pensada para rack e uso contínuo |
| Uso em data center | Não previsto na licença dos drivers | Previsto nas versões para servidor | Projetada para isso |
| Indicada para | Testes, protótipos e modelos pequenos | Inferência de modelos médios e grandes | Inferência em produção, treinamento e LLMs em escala |
As características apresentadas são referências gerais. Os recursos variam conforme o modelo e a versão de cada placa.
Quanta memória de vídeo (VRAM) a placa precisa ter?
A VRAM é o primeiro critério para escolher uma placa de vídeo para IA. Ela precisa comportar os pesos do modelo, o contexto das conversas (KV Cache) e uma margem de segurança.
Uma regra prática ajuda a estimar. Em precisão FP16, cada bilhão de parâmetros ocupa cerca de 2 GB. Com quantização em 4 bits, esse valor cai para cerca de 0,5 GB, com alguma perda de precisão.
| Tamanho do modelo | Pesos em FP16 | Pesos em 4 bits |
|---|---|---|
| 7 a 8 bilhões de parâmetros | Cerca de 16 GB | Cerca de 4 a 5 GB |
| 30 a 34 bilhões | Cerca de 60 a 70 GB | Cerca de 17 a 20 GB |
| 70 bilhões | Cerca de 140 GB | Cerca de 35 a 40 GB |
Os valores consideram só os pesos. Na prática, uma placa de 24 GB roda bem modelos pequenos, mas fica no limite com modelos maiores ou contextos longos.
Qual a melhor placa de vídeo para IA?
Não existe uma única melhor placa de vídeo para IA. A melhor escolha é a que comporta o modelo com folga, atende o volume de uso e pode operar no ambiente onde vai rodar.
Como referência, a tabela abaixo relaciona os usos mais comuns às categorias de placa:
| Uso | Categoria indicada | Exemplos |
|---|---|---|
| Estudos, testes e protótipos | Consumo | RTX 4090, RTX 5090 |
| Inferência de modelos pequenos em produção | Data center de entrada | L4 |
| Inferência de modelos médios e grandes | Profissional ou data center | RTX PRO 6000 Blackwell, L40S |
| LLMs grandes com muitos usuários | Data center | H100, H200 |
| Treinamento e os maiores modelos | Data center | H200, B200 em várias GPUs |
Antes de escolher pelo nome da placa, confirme se a memória comporta o modelo, como mostra a seção anterior.
Como avaliar o custo-benefício de uma placa de vídeo para IA
Em IA, custo-benefício não é pagar menos pela placa. É pagar pelo que o projeto realmente usa, sem faltar memória nem sobrar capacidade parada.
- Compare custo por GB de VRAM: como a memória define o tamanho do modelo, ela costuma ser o melhor critério de comparação entre placas;
- Considere a quantização: rodar o modelo em 4 ou 8 bits reduz a memória necessária e pode permitir uma placa menor, com alguma perda de precisão;
- Separe inferência de treinamento: para inferência, placas como L4 e L40S podem entregar mais por investimento do que aceleradores de topo;
- Inclua a operação na conta: energia, refrigeração, manutenção e tempo da equipe pesam tanto quanto o preço do hardware.
Como rodar IA localmente com uma placa de vídeo
Rodar IA localmente é executar o modelo no próprio computador ou servidor, sem depender de uma API externa. É uma forma comum de testar modelos abertos e manter os dados dentro da empresa.
Ferramentas como Ollama, LM Studio e llama.cpp facilitam esse processo. Elas baixam modelos já quantizados e rodam com poucos comandos.
Para uso local, uma placa de consumo com 16 a 32 GB de VRAM costuma bastar para modelos de 7 a 14 bilhões de parâmetros. Modelos maiores exigem mais memória ou várias placas.
O limite aparece quando o modelo local precisa atender a empresa inteira. Nesse ponto, ele passa a ser um serviço de produção, com as exigências descritas a seguir.
NVIDIA ou AMD: qual placa de vídeo usar para IA?
A NVIDIA domina o mercado de IA principalmente por causa do CUDA, a plataforma de software usada pela maioria dos frameworks, bibliotecas e modelos. Na prática, quase tudo em IA funciona primeiro em placas NVIDIA.
A AMD oferece o ROCm, sua plataforma para IA, e aceleradores de data center como a Instinct MI300X, com 192 GB de memória. O suporte em frameworks como PyTorch evoluiu bastante, mas ainda exige mais validação, principalmente em placas de consumo Radeon.
Para a maioria das empresas, a NVIDIA continua sendo a escolha de menor risco. A AMD pode fazer sentido em projetos com equipe técnica experiente e compatibilidade testada com antecedência.
Treinamento ou inferência: o que muda na escolha?
Treinar um modelo é ensinar a IA, ajustando bilhões de parâmetros com grandes volumes de dados. É a etapa mais pesada, que pede muita memória e, muitas vezes, várias GPUs interligadas.
Inferência é usar o modelo já treinado para responder perguntas ou fazer previsões. Pede menos poder bruto, mas exige baixa latência e estabilidade, principalmente quando muitos usuários acessam ao mesmo tempo.
A maioria das empresas não treina modelos do zero. O uso mais comum é inferência e fine-tuning de modelos abertos. Por isso, memória suficiente e operação contínua costumam pesar mais do que o desempenho máximo da placa.
Quando uma RTX de consumo dá conta
Uma placa GeForce RTX é uma boa escolha em situações como:
- Prototipagem: testar ideias e validar um caso de uso antes de investir em infraestrutura;
- Modelos pequenos: rodar modelos de até cerca de 13 bilhões de parâmetros quantizados, com poucos usuários;
- Fine-tuning leve: ajustar modelos pequenos com dados próprios, em ambiente de desenvolvimento;
- Uso individual: estações de trabalho de cientistas de dados e desenvolvedores.
Quando uma RTX não sustenta produção
O problema aparece quando o projeto sai do teste e passa a atender usuários reais, integrações e APIs, 24 horas por dia. Nesse ponto, cinco limites pesam:
- Memória: com 24 a 32 GB, a placa não comporta modelos grandes nem contextos longos com vários usuários. O resultado são erros de falta de memória (Out of Memory);
- Integridade dos dados: GPUs profissionais e de data center trazem correção de erros de memória (ECC) validada para carga contínua, o que reduz o risco de resultados corrompidos em execuções longas;
- Refrigeração: as placas de consumo são pensadas para picos de uso em gabinetes abertos. Sob carga contínua, ou várias placas lado a lado, tendem a perder desempenho por aquecimento;
- Licenciamento: a licença dos drivers GeForce não permite o uso em data center, com exceção de processamento de blockchain. Isso cria risco contratual para empresas;
- Disponibilidade: uma estação de trabalho não tem fontes redundantes, rede redundante nem refrigeração controlada, como um Data Center Tier III.
Comprar a placa ou contratar GPU dedicada?
Comprar uma placa de vídeo para IA parece mais simples, mas o custo não para no hardware. Entram na conta servidor compatível, energia, refrigeração, espaço físico, manutenção e o time que vai operar tudo.
Também há o prazo. GPUs de data center costumam ter fila de entrega e processo de importação. E o hardware envelhece rápido: novas gerações chegam a cada um ou dois anos.
A alternativa é contratar uma GPU Dedicada: a placa fica em um Data Center, com recursos exclusivos, e a empresa paga uma mensalidade. O modelo faz sentido quando o projeto já tem uso contínuo e a empresa quer previsibilidade de custo sem imobilizar capital.
Para entender os outros componentes do servidor, veja como CPU, RAM, storage e rede afetam um servidor GPU para IA em produção.
Como escolher a placa de vídeo para IA da sua empresa
- Defina o caso de uso: treinamento, fine-tuning ou inferência, e qual modelo será usado;
- Estime a VRAM: calcule o espaço dos pesos, some o KV Cache no pico de uso e reserve de 20% a 30% de folga;
- Meça a demanda: número de usuários simultâneos, requisições por segundo e tamanho médio dos contextos;
- Escolha a categoria: consumo para testes, profissional para inferência de modelos médios e grandes, data center para treinamento e LLMs em escala;
- Defina onde a placa vai rodar: compra própria ou GPU dedicada em Data Center, comparando custo total, prazo e operação;
- Faça uma prova de conceito: teste com carga parecida com a real antes de fechar contratos longos.
Se o projeto envolve agentes de IA, veja também como dimensionar a infraestrutura para agentes de IA em produção.
A abordagem da EVEO para IA em produção
A escolha da placa deve fazer parte do dimensionamento da infraestrutura, considerando o modelo, o volume de uso e os requisitos de disponibilidade.
Com a GPU Dedicada da EVEO, sua empresa conta com recursos exclusivos para levar a IA para produção com previsibilidade. Entre os recursos disponíveis estão:
- Placa NVIDIA inteira e isolada fisicamente, para treinamento, fine-tuning e inferência;
- 5 Data Centers Tier III, com SLA de 99,5% de uptime, conforme contrato;
- Mensalidade fixa em reais, sem variação cambial;
- Tráfego ilimitado;
- Suporte técnico 24/7 em português;
- Monitoramento e atualizações com os Serviços Gerenciados.
Escolha a GPU certa para o seu projeto
Não sabe qual placa escolher? Os especialistas da EVEO avaliam o modelo, o volume de uso e a memória necessária e indicam a configuração adequada.
Fale com um especialistaPerguntas frequentes sobre placa de vídeo para IA
Qual a melhor placa de vídeo para IA?
Depende do uso. Para testes e modelos pequenos, uma GeForce RTX com 24 ou 32 GB costuma bastar. Para inferência de modelos médios e grandes, placas profissionais como a RTX PRO 6000 Blackwell são uma opção comum. Para treinamento e LLMs em escala, GPUs de data center como H200 e B200 são as mais indicadas.
Placa de vídeo gamer serve para IA?
Serve para prototipagem, estudos e modelos pequenos. Para produção corporativa contínua, os limites de memória, refrigeração e licenciamento tornam as GPUs profissionais ou de data center mais adequadas.
Quanta VRAM é necessária para rodar IA?
Como regra prática, cada bilhão de parâmetros ocupa cerca de 2 GB em FP16 e cerca de 0,5 GB com quantização em 4 bits. Um modelo de 70 bilhões de parâmetros precisa de cerca de 140 GB em FP16 ou de 35 a 40 GB em 4 bits, sem contar o KV Cache e a folga de segurança.
Por que a IA usa placa de vídeo e não só o processador?
Porque modelos de IA fazem um volume enorme de cálculos de matrizes, que podem ser executados em paralelo. A GPU tem milhares de núcleos feitos para isso, enquanto a CPU tem poucos núcleos otimizados para tarefas em sequência.
Posso usar GeForce RTX em servidor de data center?
A licença dos drivers GeForce não permite o uso em data center, com exceção de processamento de blockchain. Para servidores, a NVIDIA oferece placas profissionais e de data center, com drivers e licenças próprios para esse ambiente.
Vale mais a pena comprar uma placa de vídeo para IA ou contratar GPU dedicada?
Comprar faz sentido para uso pontual ou em desenvolvimento. Para uso contínuo em produção, a GPU dedicada evita investimento inicial alto, custos de energia e refrigeração, prazo de importação e risco de obsolescência, com mensalidade previsível.
NVIDIA ou AMD: qual é melhor para IA?
Para a maioria das empresas, a NVIDIA, porque o CUDA é a plataforma usada pela maior parte dos frameworks e modelos de IA. A AMD, com o ROCm e aceleradores como a Instinct MI300X, é uma alternativa que exige mais validação de compatibilidade.
Dá para rodar IA localmente em uma placa de vídeo comum?
Sim. Com ferramentas como Ollama, LM Studio e llama.cpp, uma placa de consumo com 16 a 32 GB de VRAM roda modelos de 7 a 14 bilhões de parâmetros quantizados. Para atender muitos usuários, o ideal é migrar para GPUs profissionais ou de data center.