

Escrito por
Redação EVEO
Conteúdos produzidos por especialistas da EVEO, com experiência em infraestrutura de TI, servidores dedicados, private cloud, GPUs e soluções para ambientes de alta performance. Desde 2014, a empresa oferece soluções de infraestrutura para empresas no Brasil e no exterior.
EM RESUMO
Contratar um servidor multi-GPU para deep learning no Brasil exige avaliar não apenas a quantidade de VRAM, mas também a tecnologia de interconexão entre as GPUs, a latência de rede e a soberania da infraestrutura. Provedores nacionais de bare metal e nuvem privada oferecem controle total sobre o hardware, eliminam egress fees e garantem conformidade com a LGPD para projetos de IA que lidam com dados corporativos sensiveis.
- NVLink e NVSwitch são decisivos para treinamento distribuido: oferecem até 900 GB/s de bandwidth entre GPUs, contra 32 GB/s do PCIe 4.0;
- Para modelos de 70B+ parametros em FP16, um servidor com 4 a 8 GPUs NVIDIA A100 ou H100 é o ponto de partida enterprise;
- Contratar no Brasil garante custo previsivel em reais, dados sob jurisdição nacional e auditoria fisica do ambiente.
Este artigo é para voce se:
- Voce lidera um time de machine learning e precisa escalar de uma GPU para multi-GPU para treinar modelos maiores ou reduzir o tempo de treinamento.
- Voce é responsavel pela compra ou locacao de infraestrutura e precisa entender onde contratar servidor multi-GPU no Brasil com suporte tecnico local.
- Voce trabalha com dados sensiveis e precisa garantir que os datasets de treinamento nao saiam do territorio nacional durante o processamento.
Neste artigo:
- O que é um servidor multi-GPU e por que ele acelera o deep learning
- Quando o deep learning exige mais de uma GPU
- NVLink e InfiniBand: por que a conexao entre GPUs importa
- Onde contratar servidor multi-GPU no Brasil
- Quanto custa um servidor multi-GPU para deep learning
- Como garantir soberania de dados em treinamentos de IA
- A abordagem da EVEO
- Perguntas frequentes
O que é um servidor multi-GPU e por que ele acelera o deep learning
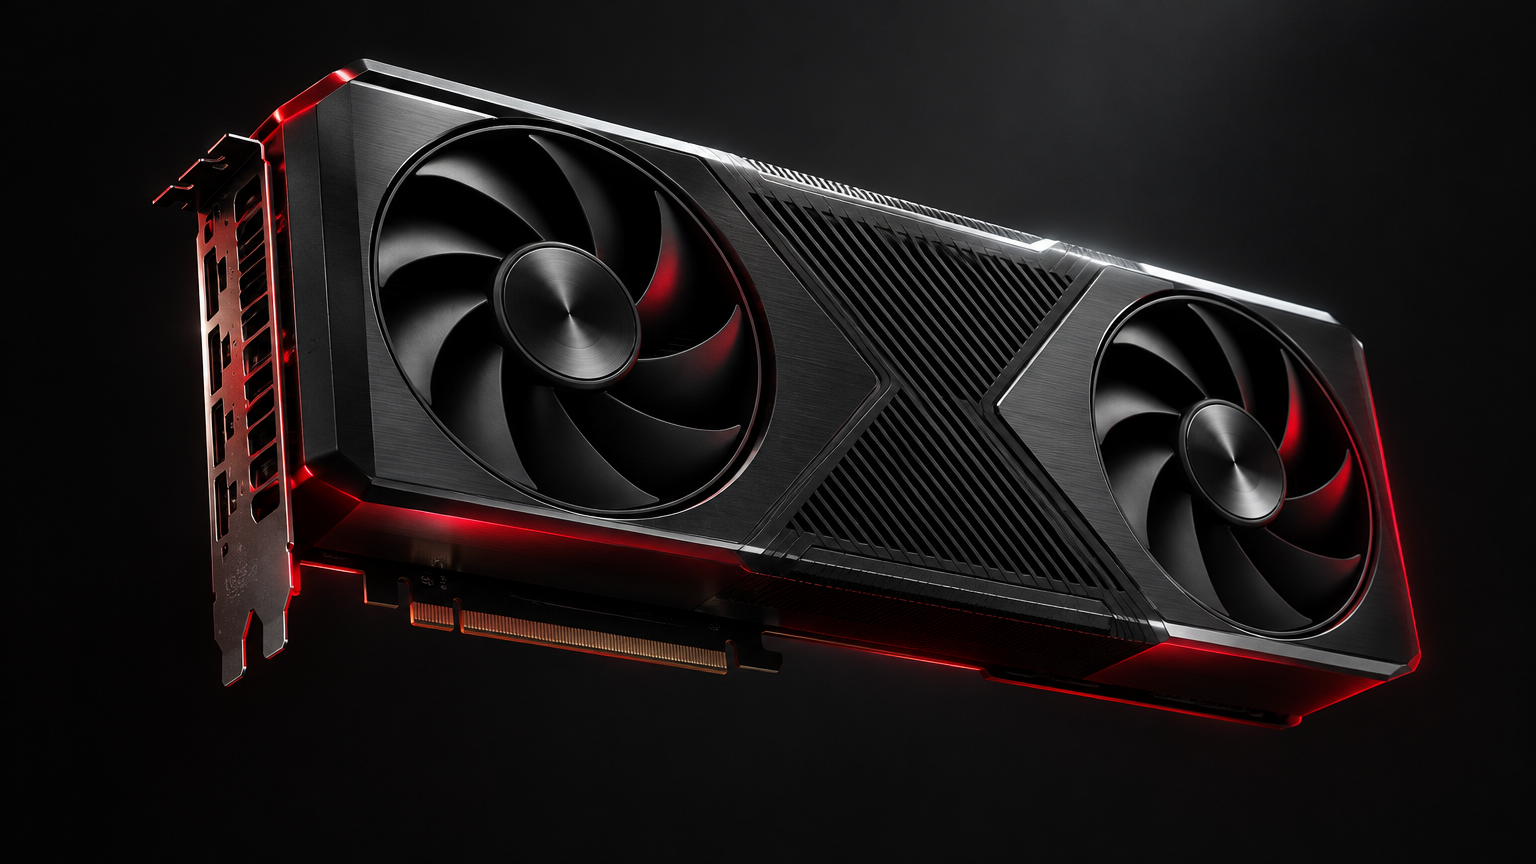
Servidor multi-GPU é uma maquina bare metal ou um no de computacao equipado com duas ou mais unidades de processamento grafico trabalhando em paralelo sob um mesmo sistema operacional, compartilhando acesso a memoria RAM do host e a rede de alta velocidade. Diferente de um cluster geograficamente distribuido, onde servidores independentes se comunicam pela rede, o multi-GPU concentra o poder de processamento em um unico chassis, permitindo que frameworks de deep learning distribuam automaticamente cargas de trabalho entre as GPUs atraves de bibliotecas como NCCL da NVIDIA.
O deep learning moderno, especialmente no treinamento de grandes modelos de linguagem, visao computacional e sistemas multimodais, exige operacoes matriciais massivas que uma unica GPU nao consegue executar em tempo viavel ou simplesmente nao comporta por limitacao de memoria. Um modelo com 175 bilhoes de parametros pode exigir terabytes de VRAM durante o treinamento. Um servidor com 8 GPUs NVIDIA H100, por exemplo, oferece ate 640 GB de VRAM agregada (80 GB por GPU), viabilizando modelos que seriam impossiveis em hardware unico.
Alem da memoria, o ganho de velocidade é substancial. O treinamento de uma rede neural em uma unica GPU pode levar semanas. Distribuir essa carga entre 4 ou 8 GPUs bem conectadas reduz o tempo proporcionalmente, desde que a arquitetura de interconexao nao se torne um gargalo. É por isso que escolher um servidor GPU para empresas exige olhar nao apenas para a GPU individual, mas para como elas conversam entre si.
Quando o deep learning exige mais de uma GPU
A transicao de single-GPU para multi-GPU geralmente acontece por um de tres motivos: falta de memoria de video, tempo de treinamento excessivo ou a necessidade de processar batches maiores para estabilidade do gradiente. Cada um desses gargalos exige uma estrategia de paralelismo diferente.
Paralelismo de dados: a abordagem mais comum. Cada GPU recebe um subconjunto diferente do batch de treinamento, processa o forward e backward pass independentemente e, ao final, sincroniza os gradientes antes de atualizar os pesos do modelo. Funciona bem quando o modelo inteiro cabe na VRAM de uma GPU, mas o dataset é grande o suficiente para justificar multiplas unidades. Frameworks como PyTorch DistributedDataParallel e TensorFlow Strategy tornam essa distribuicao quase transparente para o desenvolvedor.
Paralelismo de modelo: quando o proprio modelo é grande demais para uma unica GPU. As camadas da rede neural sao divididas entre as GPUs, como se cada uma fosse responsavel por um andar de uma fabrica. A ativacao de uma GPU alimenta a proxima em sequencia. Essa abordagem é essencial para modelos de linguagem com mais de 70 bilhoes de parametros em precisao FP16. A desvantagem é que a latencia de comunicacao entre GPUs se torna critica, ja que toda ativacao precisa atravessar o barramento a cada passagem forward ou backward.
Paralelismo hibrido: combina ambos. Grandes laboratorios de IA usam tecnicas como pipeline parallelism e tensor parallelism simultaneamente, distribuindo tanto os dados quanto as camadas do modelo. Essa configuracao é padrao para modelos como GPT-4, LLaMA 3 405B e Claude, exigindo dezenas ou centenas de GPUs interconectadas por NVLink e InfiniBand.
| Estrategia de Paralelismo | Quando Usar | Censo Minimo de GPUs | Gargalo Principal |
|---|---|---|---|
| Paralelismo de dados | Modelo cabe em uma GPU, dataset é grande | 2 a 8 GPUs | Sincronizacao de gradientes (all-reduce) |
| Paralelismo de modelo | Modelo excede a VRAM de uma GPU | 4 a 8 GPUs | Latencia entre camadas (pipeline) |
| Paralelismo hibrido | Modelos 70B+ parametros, treinamento do zero | 8+ GPUs (multi-no) | Topologia de rede e overhead de comunicacao |
NVLink e InfiniBand: por que a conexao entre GPUs importa
Se voce colocar 8 GPUs em um servidor sem atencao a interconexao, pode acabar com um sistema caro que performa pior do que 4 GPUs bem conectadas. A razao é simples: deep learning multi-GPU exige troca constante de dados entre as unidades. Se o barramento for lento, as GPUs passam mais tempo esperando do que calculando.
PCIe: a interface padrao de expansao. Um slot PCIe 4.0 x16 oferece aproximadamente 32 GB/s de largura de banda. Para inferencia ou treinamentos simples com paralelismo de dados em poucas GPUs, isso pode ser suficiente. Mas para modelos grandes com paralelismo de modelo, o PCIe vira gargalo.
NVLink: tecnologia proprietaria da NVIDIA para conexao direta GPU-a-GPU. Cada link NVLink 4.0 oferece 112,5 GB/s por direcao, e a NVSwitch permite conectar ate 18 GPUs em uma topologia de malha completa com largura de banda agregada de 900 GB/s. Isso significa que uma GPU pode acessar a memoria de outra GPU quase como se fosse sua propria. Para treinamento de grandes modelos de linguagem, NVLink nao é luxo: é requisito de performance.
InfiniBand: usado quando o paralelismo extrapola um unico servidor e envolve multiplos nos em um cluster. Oferece latencia abaixo de 600 nanossegundos e largura de banda de ate 400 Gbps por porta. Em ambientes de supercomputacao para IA, InfiniBand é o padrao para interconectar racks inteiros de servidores multi-GPU.
Onde contratar servidor multi-GPU no Brasil
O mercado brasileiro de infraestrutura para IA cresceu nos ultimos anos, mas a oferta de multi-GPU enterprise ainda é concentrada. Existem tres vias principais para contratar: nuvens publicas internacionais, provedores nacionais de bare metal e provedores de nuvem privada.
Nuvens publicas (hyperscalers): AWS, Google Cloud e Azure oferecem instancias multi-GPU como P4d, A2 e NC A100 v4. A vantagem é a elasticidade: voce sobe e desliga clusters em minutos. A desvantagem, para o cenario brasileiro, é tripla: os dados fisicamente podem estar em Sao Paulo, mas o acesso administrativo, os logs de hypervisor e os subprocessadores sao gerenciados internacionalmente; os custos de egress fee para transferir datasets de treinamento ou checkpoints podem ultrapassar o proprio custo da computacao; e a faturacao em dolares expoe o projeto a variacao cambial.
Bare metal nacional: voce aluga ou hospeda servidores fisicos em servidores dedicados bare metal dentro de data centers no Brasil. O hardware é seu por exclusividade: nenhum outro cliente compartilha as GPUs, a rede ou o barramento NVLink. Voce instala o sistema operacional, os drivers NVIDIA, o CUDA, o cuDNN e os frameworks de sua escolha. A latencia de rede interna é minima e o controle total permite otimizacoes que nao sao possiveis em ambientes virtualizados.
Nuvem privada nacional: um meio-termo que oferece virtualizacao sobre hardware dedicado, operado por um provedor brasileiro. A diferenca crucial para a nuvem publica é que a infraestrutura fisica permanece sob controle nacional, com dados restritos ao territorio brasileiro e faturacao em reais. Para deep learning, a nuvem privada funciona bem quando o time de ML precisa de isolamento de projetos, snapshots de ambiente e alguma elasticidade, mas sem abrir mao da soberania dos dados.
| Criterio | Nuvem Publica Internacional | Bare Metal Nacional | Nuvem Privada Nacional |
|---|---|---|---|
| Soberania de dados | Baixa: subprocessadores internacionais | Total: controle fisico completo | Alta: provedor nacional, dados no Brasil |
| Acesso a NVLink | Parcial: depende da instancia | Total: NVLink e NVSwitch nativos | Variavel: exige passthrough de GPU |
| Custo previsivel | Baixo: egress fees e cambio imprevisiveis | Alto: fixo mensal em reais, sem egress | Alto: fixo mensal em reais, sem egress |
| Setup e manutencao | Rapido: APIs e templates prontos | Moderado: requer expertise interna | Moderado: templates pre-configurados |
| Escalabilidade | Quase ilimitada | Limitada pelo hardware fisico | Moderada: adicao programada de nos |
| Conformidade LGPD | Complexa: auditoria limitada | Direta: logs e acesso controlados localmente | Direta: compliance gerenciado no Brasil |
Para projetos de deep learning com dados corporativos sensiveis, a escolha entre servidor dedicado ou servidor nuvem no Brasil tende a favorecer o bare metal ou a nuvem privada nacional. A nuvem publica internacional so se justifica para pesquisa academica, prototipagem rapida ou datasets ja anonimizados.
Quanto custa um servidor multi-GPU para deep learning
O custo de um servidor multi-GPU varia mais pela escolha da GPU do que por qualquer outro componente. Uma NVIDIA A100 80GB tem preco de mercado significativamente maior que uma A10 ou L40S, e a H100 80GB supera ambas. Um servidor com 8x A100 pode representar um investimento que justifica analise de TCO (total cost of ownership) em horizontes de 12 a 36 meses.
Alem do hardware, os custos ocultos merecem atencao. Em hyperscalers, o egress fee para baixar um dataset de 10 TB ou sincronizar checkpoints entre regioes pode adicionar milhares de dolares mensais a fatura. Energia eletrica é outro fator: um servidor com 8 GPUs H100 pode consumir mais de 10 kW sob carga plena, o que em data centers internacionais gera cobranca adicional de energia (power surcharge). Provedores nacionais que incluem energia no pacote fixo eliminam essa incerteza.
O storage tambem escala com o projeto. Datasets de imagens de alta resolucao, video ou texto tokenizado para LLMs ocupam terabytes. Checkpoints de modelos grandes (salvamentos intermediarios do treinamento) adicionam dezenas de gigabytes a cada gravacao. SSD NVMe enterprise de 15 a 30 TB por servidor é configuracao comum para projetos serious de deep learning.
Como garantir soberania de dados em treinamentos de IA
Treinar modelos de IA com dados corporativos, de clientes ou de usuarios exige atencao redobrada à Lei Geral de Protecao de Dados (LGPD). Quando voce contrata infraestrutura multi-GPU, o tratamento desses dados acontece de forma concentrada e intensiva, o que amplifica os riscos de vazamento ou uso indevido.
Jurisdicao fisica: o primeiro pilar da soberania é garantir que os servidores fisicos estejam localizados no Brasil. Isso assegura que dados em repouso e em processamento estejam sob a jurisdicao da legislacao brasileira. A EVEO opera data centers Tier III em Cotia/SP, Osasco/SP, Curitiba/PR, Fortaleza/CE e Miami/FL, oferecendo opcoes de hospedagem nacional para projetos que exigem permanencia dos dados no pais.
Isolamento de ambiente: em um servidor multi-GPU bare metal, nao ha compartilhamento de hardware com outros clientes. Isso elimina riscos de side-channel attacks e garante que a memoria das GPUs seja completamente reconfigurada entre usos. Em ambientes de nuvem privada, o isolamento por VLANs e firewalls de proxima geracao mantem o trafego de treinamento separado da rede corporativa.
Cadeia de custodia dos dados: desde a ingestao do dataset ate a exportacao do modelo treinado, cada etapa deve ser logada. Quem acessou o servidor, quando os dados foram carregados, quem baixou checkpoints e onde o modelo final foi armazenado. Ferramentas de SIEM (Security Information and Event Management) e logs imutaveis sao pratica padrao em ambientes que buscam conformidade total.
Setores regulados: operadoras de saude, instituicoes financeiras e orgaos publicos possuem normas adicionais que restringem ou proibem o processamento de dados fora do Brasil. Para esses setores, a escolha de onde contratar servidor multi-GPU nao é apenas uma decisao de performance ou custo: é um requisito de compliance. Manter a infraestrutura nacional, com contrato que garanta ausencia de subprocessadores internacionais, é a forma mais segura de atender a essas obrigacoes.
A abordagem da EVEO
A EVEO, com mais de 10 anos de mercado, 5.000 clientes e 130 colaboradores, oferece infraestrutura multi-GPU para deep learning em data centers Tier III no Brasil. A empresa atende exclusivamente pessoas juridicas, mediante CNPJ, com foco corporativo e sem atendimento a pessoa fisica ou jogos online.
O portfolio de GPU da EVEO inclui configuracoes com multiplas NVIDIA A100, H100 e L40S, com suporte a NVLink e NVSwitch para treinamento de modelos grandes. Os servidores sao entregues como bare metal dedicado ou como parte de ambientes de nuvem privada, sempre com dados hospedados em territorio nacional.
A EVEO nao cobra egress fee. O custo é previsivel em reais, o que permite que times de ML e departamentos de infraestrutura façam planejamento financeiro sem surpresas de fatura ou exposicao cambial. A soberania de dados é garantida por contrato, com possibilidade de auditoria fisica e logica nos data centers.
Para quem precisa escalar de uma GPU para multi-GPU, a equipe de engenharia da EVEO auxilia no dimensionamento correto: quantidade de VRAM agregada necessaria, configuracao de NVLink, escolha entre A100 e H100 conforme o modelo de IA, e adequacao de RAM CPU, storage NVMe e rede para evitar gargalos.
Se voce precisa contratar servidor multi-GPU para deep learning no Brasil, com garantia de que seus dados de treinamento nunca saiam da infraestrutura nacional, a EVEO tem a arquitetura adequada.
Perguntas frequentes
1. O que é um servidor multi-GPU e como ele funciona no deep learning?
Um servidor multi-GPU é uma maquina equipada com duas ou mais placas de video trabalhando em paralelo sob um mesmo sistema operacional. No deep learning, frameworks como PyTorch e TensorFlow distribuem automaticamente as operacoes entre as GPUs, seja dividindo o dataset (paralelismo de dados) ou dividindo o proprio modelo em partes (paralelismo de modelo). Isso permite treinar redes neurais maiores e reduzir o tempo de treinamento de semanas para dias.
2. Quando devo escolher um servidor com 2, 4 ou 8 GPUs?
Use 2 GPUs quando o modelo cabe em uma unica placa, mas voce quer dobrar a velocidade de treinamento ou processar batches maiores. Use 4 GPUs quando o modelo excede a VRAM de uma unica GPU ou quando o dataset é muito extenso. Use 8 GPUs para modelos de 70 bilhoes de parametros ou mais, treinamento do zero de LLMs ou cargas de visao computacional com datasets de alta resolucao. A decisao final depende do tamanho do modelo, do batch size desejado e do prazo de treinamento.
3. Qual a diferenca entre NVLink e PCIe para conectar GPUs?
PCIe é a interface padrao de expansao, com largura de banda de cerca de 32 GB/s no PCIe 4.0 x16. NVLink é uma tecnologia dedicada da NVIDIA para comunicacao direta GPU-a-GPU, oferecendo ate 112,5 GB/s por link e, com NVSwitch, permitindo malha completa entre todas as GPUs do servidor. Para deep learning, NVLink reduz drasticamente o tempo de sincronizacao entre GPUs durante o treinamento, sendo praticamente obrigatorio para modelos grandes com paralelismo de modelo.
4. Posso usar multi-GPU em nuvem publica ou preciso de bare metal?
Voce pode usar multi-GPU em nuvem publica, mas com limitacoes. Instancias de GPU em hyperscalers raramente oferecem NVLink diretamente acessivel ao usuario, e o compartilhamento do host fisico pode introduzir variabilidade de performance (noisy neighbors). Bare metal é preferido quando voce precisa de controle total sobre drivers, bibliotecas e topologia de rede entre GPUs, ou quando a conformidade regulatoria exige isolamento fisico completo do hardware. Para prototipagem e pesquisa, nuvem publica funciona; para producao enterprise e dados sensiveis, bare metal ou nuvem privada sao mais adequados.
5. Quanto de armazenamento e RAM CPU são necessarios para um servidor multi-GPU?
A regra pratica é: a RAM CPU deve ser pelo menos duas vezes a VRAM agregada das GPUs. Um servidor com 8x A100 80GB (640 GB VRAM total) precisa de 1,5 a 2 TB de RAM CPU para evitar starvation. O storage depende do dataset: projetos de LLM com datasets tokenizados de centenas de gigabytes e checkpoints frequentes exigem 15 a 30 TB de SSD NVMe por servidor. Redes de 25 Gbps são o minimo aceitavel; 100 Gbps é o ideal para ingestao de dados em multi-GPU.
6. Onde contratar servidor multi-GPU para deep learning no Brasil?
No Brasil, voce pode contratar servidor multi-GPU atraves de provedores nacionais de bare metal e nuvem privada que operem data centers Tier III no territorio nacional. A vantagem de contratar local é a soberania de dados (garantia de que informacoes permanecem sob jurisdicao brasileira), o custo previsivel em reais, a ausencia de egress fees e o suporte tecnico em portugues no mesmo fuso horario. A EVEO oferece servidores multi-GPU com NVIDIA A100, H100 e L40S em suas instalacoes de Cotia/SP, Osasco/SP, Curitiba/PR e Fortaleza/CE, com opcao de bare metal dedicado ou nuvem privada corporativa.