

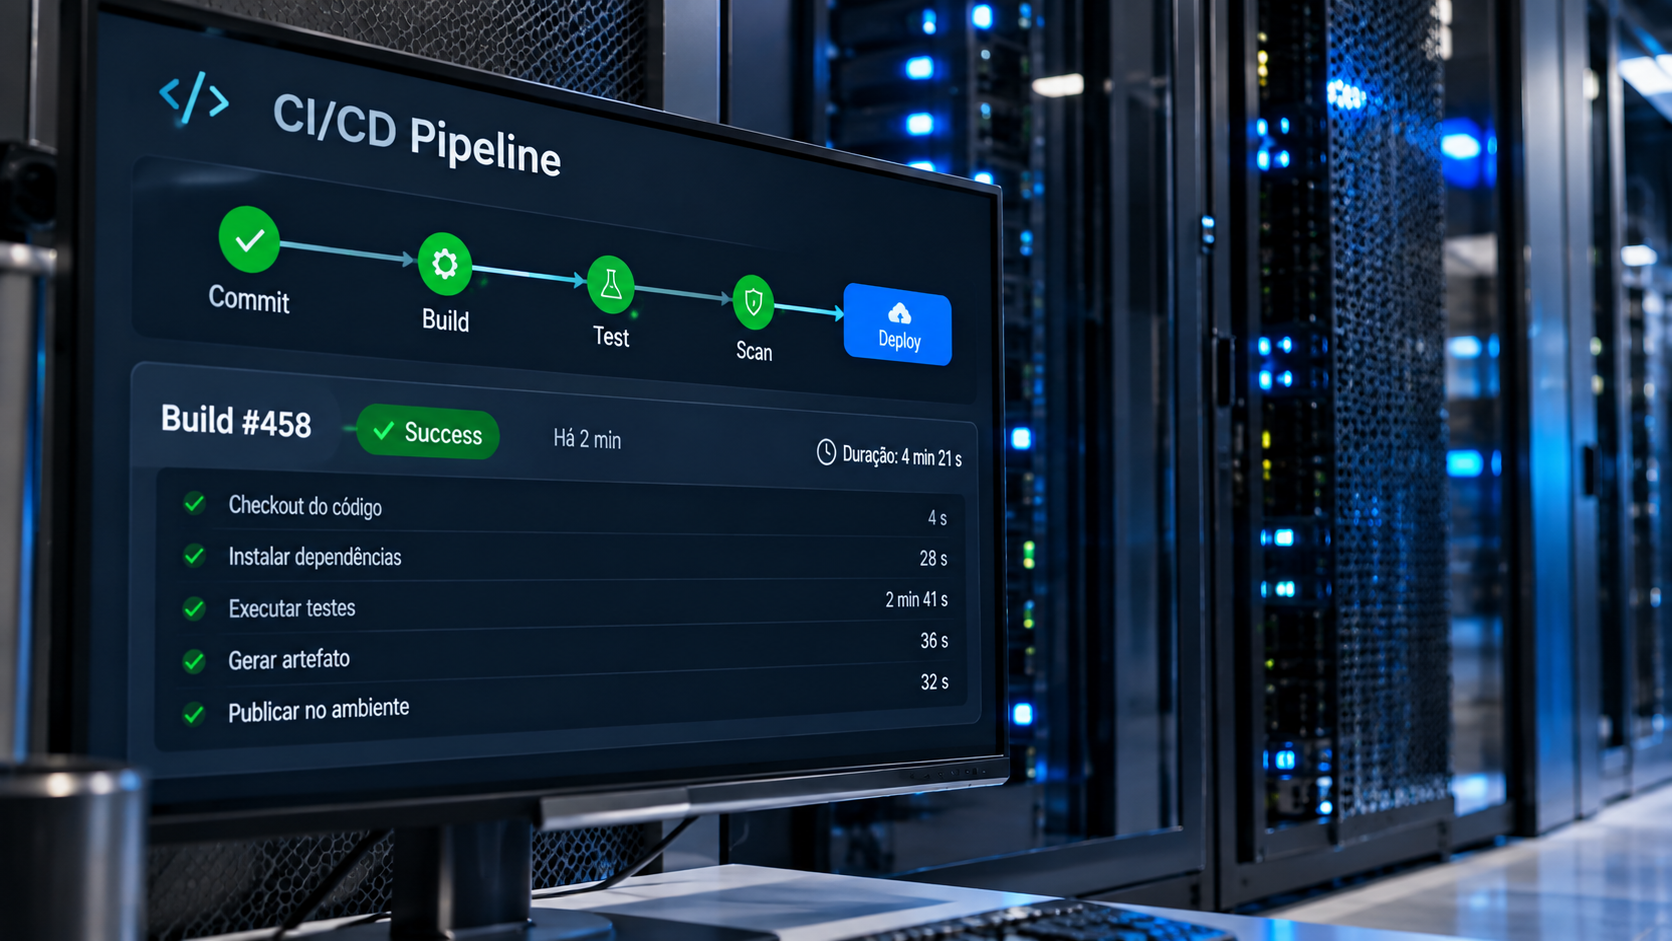

A velocidade de um pipeline de CI/CD depende diretamente da infraestrutura que executa os builds e os testes. Fila de espera, CPU compartilhada, disco lento e ausência de cache são as causas mais comuns de pipelines demorados.
- builds e testes consomem principalmente CPU, memória RAM e operações de disco;
- runners compartilhados podem gerar fila e variação de desempenho entre execuções;
- cache de dependências, de camadas Docker e de compilação reduz o tempo de cada execução;
- paralelizar testes exige núcleos suficientes e memória para vários jobs simultâneos;
- um servidor dedicado como runner self-hosted oferece desempenho previsível e custo fixo mensal.
- administra pipelines no GitLab CI, GitHub Actions, Jenkins ou ferramentas semelhantes;
- percebe que os builds demoram mais à medida que o projeto e o time crescem;
- quer reduzir o tempo de feedback dos testes automatizados;
- avalia trocar runners compartilhados por uma infraestrutura própria.
Em times de desenvolvimento, cada minuto de espera por um build se repete dezenas de vezes por dia. Um pipeline lento atrasa revisões de código, acumula alterações para o próximo deploy e reduz a frequência de entregas.
Na maioria dos casos, o problema não está no código nem na ferramenta de CI/CD, mas na infraestrutura que executa os jobs. Processadores compartilhados, pouca memória, disco lento e falta de cache transformam tarefas de poucos minutos em esperas longas.
Neste artigo, explicamos quais recursos mais influenciam builds e testes automatizados, como dimensionar um servidor dedicado para CI/CD e quais práticas ajudam a acelerar os pipelines com segurança.
O que é CI/CD e por que a infraestrutura limita a velocidade dos pipelines?
CI/CD é a sigla para Continuous Integration e Continuous Delivery (ou Continuous Deployment), em português, integração contínua e entrega contínua.
Na integração contínua, cada alteração enviada ao repositório dispara automaticamente um pipeline que compila o código, executa testes e gera artefatos. Na entrega contínua, os artefatos aprovados seguem para homologação ou produção de forma automatizada.
Cada etapa do pipeline é executada por um runner, também chamado de agente: o processo que recebe os jobs da ferramenta de CI/CD e os executa em uma máquina.
É nessa máquina que estão os limites de velocidade. Compilar código, instalar dependências, construir imagens de contêiner e rodar suítes de testes são tarefas intensivas em processamento, memória e leitura e escrita em disco.
Por que o tempo do pipeline importa para o negócio?
O tempo do pipeline determina quanto o desenvolvedor espera para saber se a alteração funciona. Quando esse feedback demora, o time muda de contexto, acumula alterações e encontra erros mais tarde, quando a correção é mais cara.
Pipelines rápidos permitem entregas menores e mais frequentes, com menos risco em cada deploy.
Quais gargalos deixam builds e testes lentos?
Antes de trocar a infraestrutura, é importante identificar onde o pipeline perde tempo. Os gargalos mais comuns são:
- Fila de espera: jobs aguardando um runner disponível antes mesmo de começar;
- CPU: compilação, empacotamento e testes limitados por poucos núcleos ou por núcleos compartilhados;
- Memória RAM: builds paralelos, contêineres e bancos de dados de teste disputando memória, o que leva ao uso de swap;
- Disco: instalação de dependências, extração de imagens e escrita de artefatos limitadas pela velocidade de leitura e escrita;
- Rede: download repetido de dependências e imagens de contêiner a cada execução;
- Ausência de cache: pipelines que reconstroem tudo do zero, mesmo quando pouca coisa mudou.
Ferramentas como GitLab CI e GitHub Actions mostram a duração de cada job e o tempo de espera na fila. Comparar esses números ajuda a separar problemas de capacidade (fila) de problemas de desempenho (execução lenta).
Runners compartilhados ou servidor dedicado: qual a diferença?
As principais plataformas de CI/CD oferecem runners hospedados, mantidos pelo próprio provedor. Eles são práticos para começar, mas têm limitações quando o volume de builds cresce.
A alternativa é registrar runners self-hosted, ou seja, executar os jobs em uma infraestrutura escolhida pela própria empresa, como um servidor dedicado.
| Critério | Runners hospedados compartilhados | Servidor dedicado como runner |
|---|---|---|
| Recursos | Máquinas virtuais com tamanhos predefinidos | CPU, RAM e discos exclusivos, definidos na contratação |
| Desempenho | Pode variar entre execuções | Previsível, sem disputa com outros clientes |
| Cache | Geralmente restaurado pela rede a cada job | Pode permanecer no disco local entre execuções |
| Modelo de custo | Variável, conforme os minutos consumidos | Mensalidade fixa, independente da quantidade de builds |
| Investimento | Conforme a tabela do provedor | Sob consulta |
| Operação | Mantida pelo provedor da plataforma | Mantida pelo time da empresa ou por serviços gerenciados |
Em times com muitos commits diários, o modelo por minuto tende a crescer junto com o volume de builds. Com um servidor dedicado, o custo mensal permanece o mesmo, e a capacidade ociosa pode ser usada para rodar mais testes sem impacto no orçamento.
Como dimensionar um servidor dedicado para CI/CD?
O dimensionamento parte de duas perguntas: quantos jobs precisam rodar ao mesmo tempo e quanto cada job consome.
CPU: quantos núcleos são necessários?
Compiladores modernos e ferramentas de teste conseguem usar vários núcleos em paralelo. Some os núcleos consumidos por job à quantidade de jobs simultâneos esperada nos horários de pico.
Projetos em linguagens compiladas, como C++, Go, Rust e Java, costumam se beneficiar mais de núcleos adicionais. Processadores com mais núcleos, como as linhas Intel Xeon e AMD EPYC, permitem executar vários pipelines sem que um job atrase o outro.
Memória RAM: como evitar o uso de swap?
Cada job consome memória para o compilador, para os contêineres e para os serviços auxiliares, como bancos de dados usados nos testes de integração. Quando a memória acaba, o sistema passa a usar swap e o build fica muito mais lento.
Estime o consumo máximo de um job, multiplique pela quantidade de jobs simultâneos e reserve uma margem para o sistema operacional e para o cache de arquivos.
Armazenamento: por que NVMe faz diferença?
Instalar dependências, extrair imagens de contêiner e gerar artefatos envolvem milhares de pequenas operações de leitura e escrita. SSDs NVMe oferecem latência baixa e alto número de operações por segundo (IOPS), o que reduz o tempo dessas etapas.
O disco também precisa de espaço para manter o cache entre execuções, as imagens de contêiner e os artefatos temporários.
Exemplo de dimensionamento
A tabela abaixo mostra um cálculo hipotético para um time que precisa executar até seis jobs simultâneos.
| Recurso | Consumo por job | 6 jobs simultâneos | Com margem |
|---|---|---|---|
| CPU | 4 núcleos | 24 núcleos | 32 núcleos |
| Memória RAM | 8 GB | 48 GB | 64 GB |
| Disco | 40 GB de trabalho | 240 GB | 1 TB NVMe, incluindo cache e imagens |
Exemplo ilustrativo. O consumo real deve ser medido nos pipelines do próprio projeto, observando os picos de uso durante os jobs mais pesados.
Como usar cache para acelerar builds?
O cache evita que o pipeline repita trabalho que já foi feito. Em um servidor dedicado, ele pode ficar no disco local, sem precisar ser baixado pela rede a cada execução.
Os principais tipos de cache em CI/CD são:
- Dependências: pacotes do npm, Maven, Gradle, pip ou Composer reaproveitados entre builds;
- Camadas de imagens Docker: etapas do Dockerfile que não mudaram deixam de ser reconstruídas;
- Compilação: ferramentas como ccache e o build cache do Gradle reaproveitam arquivos já compilados;
- Imagens base: um espelho local do registro de contêineres evita downloads repetidos.
No Docker, o BuildKit permite exportar e importar o cache de build em um diretório local:
docker buildx build \
  --cache-from type=local,src=/var/cache/buildkit \
  --cache-to type=local,dest=/var/cache/buildkit,mode=max \
  -t minha-aplicacao:ci .
Para que o cache funcione, organize o Dockerfile de forma que as etapas que mudam com menos frequência, como a instalação de dependências, venham antes da cópia do código-fonte.
Como paralelizar testes automatizados?
Suítes de testes grandes podem ser divididas em partes menores e executadas ao mesmo tempo. Essa técnica, chamada de sharding, reduz o tempo total do pipeline, desde que o servidor tenha núcleos e memória para todos os jobs simultâneos.
Como configurar a concorrência do runner?
No GitLab Runner, a quantidade de jobs simultâneos é definida pelo parâmetro concurrent, no arquivo de configuração:
# /etc/gitlab-runner/config.toml
concurrent = 6
No GitHub Actions, cada runner self-hosted executa um job por vez. Para paralelizar, registre vários runners no mesmo servidor e direcione os jobs com rótulos:
jobs:
  testes:
    runs-on: [self-hosted, linux, x64]
    strategy:
      matrix:
        parte: [1, 2, 3, 4]
Como isolar os serviços usados nos testes?
Testes de integração costumam depender de bancos de dados, filas e caches. Executar esses serviços em contêineres efêmeros, criados no início do job e removidos no fim, evita que um teste interfira no outro.
Em servidores com SSDs NVMe e memória disponível, esses serviços sobem mais rápido. Para bancos de dados de teste, também é possível usar sistemas de arquivos em memória (tmpfs), reduzindo a latência de escrita.
Como manter o ambiente de CI/CD seguro?
O runner tem acesso ao código-fonte, às credenciais de deploy e, muitas vezes, aos ambientes de produção. Por isso, a infraestrutura de CI/CD precisa do mesmo cuidado que os demais servidores críticos.
- execute cada job em contêineres ou ambientes isolados, removidos ao final da execução;
- armazene senhas e tokens no gerenciador de segredos da ferramenta de CI/CD, nunca no repositório;
- evite que pull requests de repositórios públicos ou de colaboradores externos rodem em runners self-hosted sem aprovação;
- restrinja o acesso de rede do runner apenas aos destinos necessários;
- mantenha o sistema operacional, o Docker e o próprio runner atualizados;
- faça backup das configurações do runner e dos artefatos que precisam ser preservados.
Em um servidor dedicado, os recursos físicos não são compartilhados com outras empresas, o que reduz a superfície de exposição em comparação com ambientes multi-tenant.
Como monitorar o desempenho dos pipelines?
Acompanhar métricas ao longo do tempo mostra se a infraestrutura continua adequada ao crescimento do time. Os indicadores mais úteis são:
- Tempo de fila: quanto os jobs esperam até começar a rodar;
- Duração por etapa: quais fases do pipeline concentram mais tempo;
- Taxa de acerto do cache: com que frequência o cache é reaproveitado;
- Uso de recursos: CPU, memória, disco e rede do servidor nos horários de pico;
- Taxa de falhas instáveis: testes que falham de forma intermitente, muitas vezes por falta de recursos ou por dependência de tempo.
Quando o tempo de fila cresce de forma constante, é sinal de que faltam runners. Quando a duração dos jobs aumenta sem mudanças no código, vale investigar o uso de CPU, memória e disco.
Quando vale a pena migrar o CI/CD para um servidor dedicado?
Runners hospedados atendem bem projetos pequenos e com poucos builds. A migração para um servidor dedicado costuma fazer sentido quando:
- os jobs passam muito tempo na fila nos horários de maior movimento;
- o tempo de build varia bastante entre execuções sem mudanças no código;
- o consumo de minutos cresce todo mês e dificulta a previsão do orçamento;
- os builds precisam de mais CPU, memória ou disco do que os tamanhos padrão oferecem;
- a empresa precisa de mais controle sobre o ambiente, as ferramentas instaladas e os dados processados.
Para empresas que já avaliam sair da nuvem pública em outras cargas, o pipeline de CI/CD costuma ser um bom ponto de partida. Saiba mais em migração de cloud para bare metal.
A abordagem da EVEO para CI/CD em servidores dedicados
Um servidor dedicado oferece a base para pipelines rápidos e previsíveis: recursos exclusivos, cache local persistente e capacidade para executar vários jobs ao mesmo tempo.
Com os Servidores Dedicados da EVEO, a empresa contrata hardware exclusivo e define processamento, memória RAM e armazenamento de acordo com o volume de builds e testes do time.
Entre os recursos disponíveis estão:
- servidores bare metal com recursos físicos exclusivos;
- processadores Intel Xeon Gold, Intel Xeon Platinum e AMD EPYC;
- armazenamento SSD e NVMe, com redundância RAID conforme o hardware contratado;
- tráfego ilimitado e conectividade de 1 ou 10 Gbps, conforme a configuração;
- 5 Data Centers Tier III, com SLA de 99,5% de uptime, conforme contrato;
- proteção DDoS inclusa em todos os planos;
- monitoramento e atualizações com os Serviços Gerenciados;
- suporte técnico 24/7 em português, com mais de 130 especialistas;
- ativação em até 2 dias úteis nas configurações padrão;
- mensalidade fixa em reais, sem variação cambial e sem cobrança por minuto de build.
Desde 2014, a EVEO apoia mais de 5.000 empresas que dependem de infraestrutura para entregar software. Com o servidor dimensionado para o seu pipeline, o time recebe feedback mais rápido e entrega com mais frequência.
Dimensione o servidor dedicado para o seu pipeline
Conte quantos builds e testes o seu time executa por dia. Um especialista indica a configuração de CPU, memória e armazenamento ideal para acelerar o seu CI/CD.
Fale com um especialistaPerguntas frequentes sobre servidor dedicado para CI/CD
O que é um runner self-hosted?
É um agente de CI/CD instalado em uma infraestrutura escolhida pela própria empresa, como um servidor dedicado. Ele recebe os jobs da plataforma, como GitLab CI ou GitHub Actions, e os executa com os recursos dessa máquina, em vez de usar os runners hospedados pelo provedor.
Quantos núcleos de CPU um servidor de CI/CD precisa?
Depende da quantidade de jobs simultâneos e do consumo de cada um. Uma forma prática de estimar é multiplicar os núcleos usados por um job pela quantidade de jobs executados ao mesmo tempo nos horários de pico e acrescentar uma margem para o sistema e para o cache.
Quanta memória RAM é necessária para builds paralelos?
Meça o consumo máximo de um job, incluindo contêineres e serviços de teste, e multiplique pela quantidade de jobs simultâneos. Reserve uma margem para o sistema operacional. Se o servidor começar a usar swap durante os builds, a memória está subdimensionada.
SSD NVMe acelera o pipeline de CI/CD?
Sim, especialmente nas etapas com muitas operações de leitura e escrita, como instalação de dependências, extração de imagens de contêiner e geração de artefatos. A latência baixa do NVMe reduz o tempo dessas tarefas e permite manter o cache no disco local.
É possível usar o mesmo servidor para GitLab CI e GitHub Actions?
Sim. Um servidor dedicado pode executar runners de mais de uma plataforma, desde que tenha recursos suficientes para os jobs simultâneos. É recomendável isolar as execuções em contêineres e monitorar o uso de CPU e memória para evitar disputa entre os pipelines.
Runner self-hosted é seguro para repositórios públicos?
Exige cuidado. Pull requests de colaboradores externos podem executar código arbitrário no runner. Por isso, a recomendação é restringir runners self-hosted a repositórios privados ou exigir aprovação manual antes de executar pipelines de contribuições externas.
Servidor dedicado é mais vantajoso que pagar por minuto de build?
Depende do volume. Em times com muitos builds diários, o custo por minuto tende a crescer junto com o uso, enquanto o servidor dedicado mantém uma mensalidade fixa. Além do custo, o servidor dedicado elimina a fila e oferece desempenho previsível. A comparação deve ser feita com os números reais do pipeline.
A EVEO ajuda a dimensionar o servidor para CI/CD?
Sim. Os especialistas da EVEO analisam o volume de builds, a quantidade de jobs simultâneos e o perfil das aplicações para indicar a configuração de CPU, memória e armazenamento. O servidor conta com suporte técnico 24/7 em português e pode ter monitoramento com os Serviços Gerenciados.