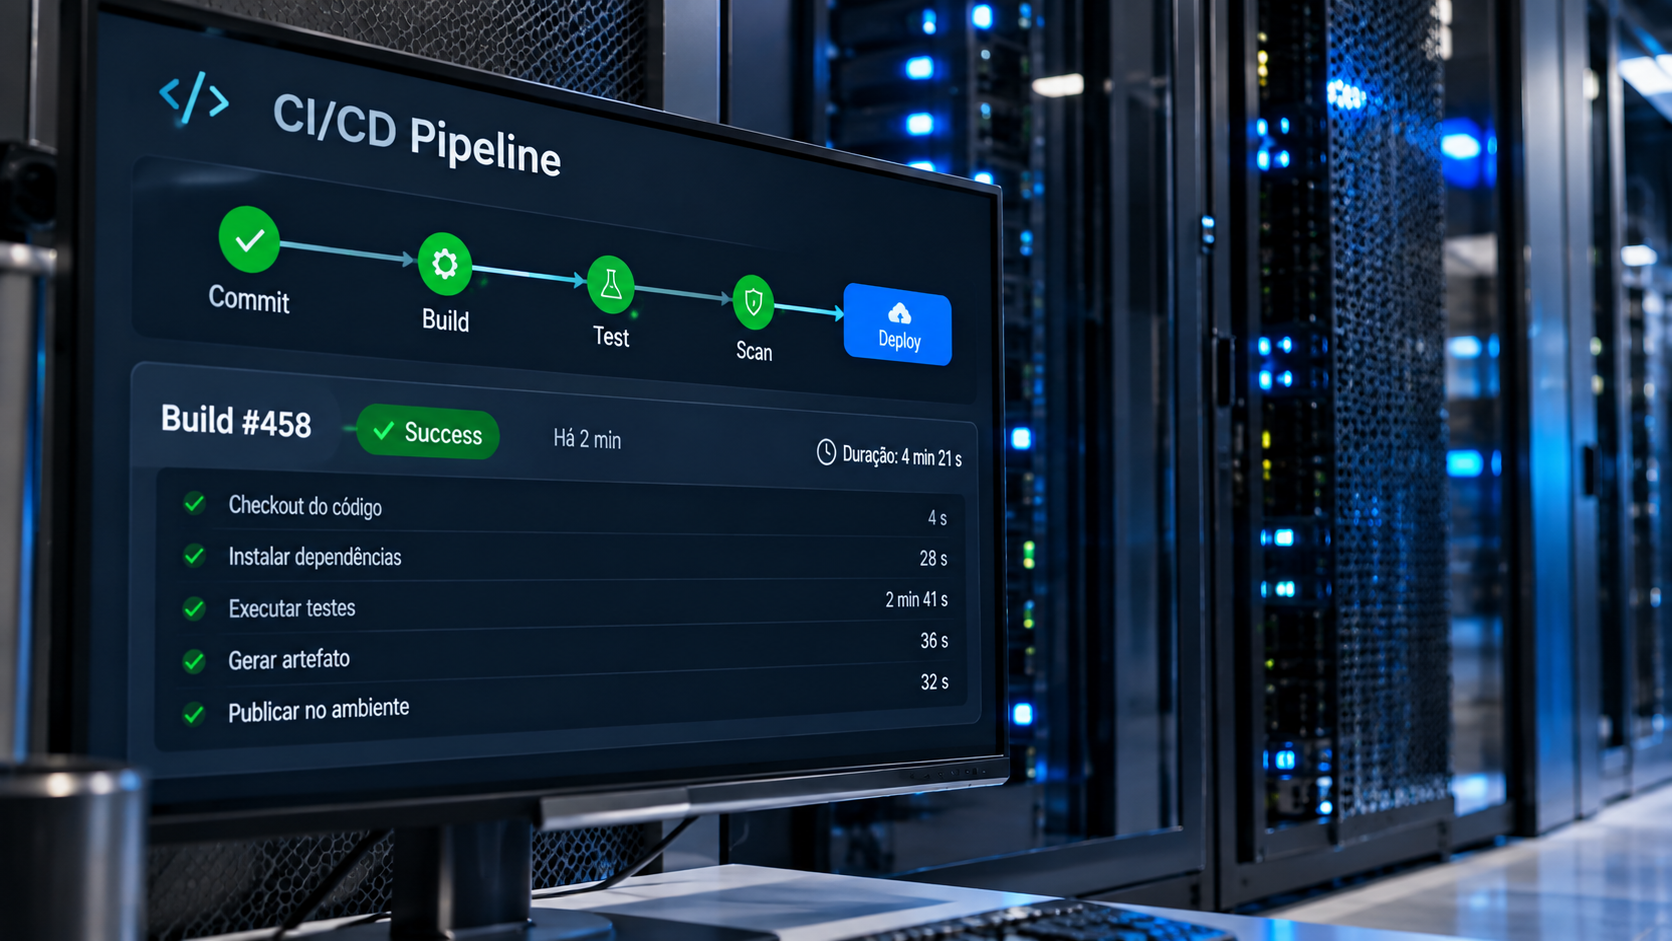



O processamento ETL envolve a extração, transformação e carregamento de dados entre diferentes sistemas. Quando CPU, memória RAM, armazenamento ou rede não acompanham a demanda, os pipelines podem apresentar lentidão, falhas e atrasos na atualização das informações.
- Gargalos de ETL podem ocorrer na extração, transformação ou carga dos dados.
- CPU e RAM influenciam diretamente operações de transformação, ordenação e agregação.
- Armazenamento NVMe pode reduzir limitações de I/O em operações intensivas.
- Paralelismo, processamento incremental e monitoramento ajudam a otimizar pipelines.
- Servidores dedicados oferecem recursos físicos exclusivos para workloads de processamento de dados.
- Administra pipelines ETL em ambientes corporativos.
- Precisa processar grandes volumes de dados em janelas reduzidas.
- Enfrenta lentidão em integrações, transformações ou cargas de dados.
- Está avaliando um servidor dedicado para aplicações de engenharia de dados.
Empresas que utilizam dados para análises, relatórios e decisões operacionais dependem de processos capazes de movimentar informações entre diferentes sistemas com eficiência.
Uma das abordagens utilizadas para essa finalidade é o ETL, responsável por extrair dados de uma ou mais fontes, aplicar transformações e carregá-los em um ambiente de destino.
O desafio aparece quando o volume de informações aumenta, novas integrações são adicionadas e os processos precisam ser concluídos dentro de janelas cada vez menores.
Nessas condições, limitações de CPU, memória, armazenamento ou conectividade podem provocar gargalos que comprometem a execução dos pipelines.
Um servidor dedicado permite dimensionar recursos físicos exclusivos para essas operações, oferecendo maior controle sobre a infraestrutura utilizada no processamento de dados.
O que é processamento ETL e como ele funciona?
ETL é a sigla para Extract, Transform, Load, ou Extração, Transformação e Carga. Trata-se de um processo utilizado para coletar informações de diferentes fontes, preparar os dados e disponibilizá-los em um sistema de destino.
Esse fluxo é comum em projetos de Business Intelligence, integração de sistemas, análise de dados e alimentação de data warehouses.
Extração de dados
Na etapa de extração, os dados são coletados de sistemas como ERPs, CRMs, bancos relacionais, APIs, arquivos e aplicações corporativas.
O desempenho depende da velocidade das fontes, da conectividade e da capacidade de executar consultas sem sobrecarregar os sistemas de origem.
Transformação dos dados
A transformação envolve operações como limpeza, padronização, validação, agregação, enriquecimento e combinação de conjuntos de dados.
Essa etapa pode exigir grande capacidade de processamento e memória, especialmente quando envolve joins, ordenações e cálculos sobre milhões de registros.
Carregamento dos dados
Após a transformação, as informações são gravadas no sistema de destino, que pode ser um banco de dados, data warehouse ou repositório analítico.
Nessa fase, a velocidade de escrita, os índices, as transações e a capacidade do destino influenciam diretamente o tempo total de execução.
Embora as três etapas sejam apresentadas separadamente, ferramentas modernas podem executá-las de forma sobreposta, utilizando streaming, buffers e processamento paralelo.
Quais são os principais gargalos no processamento ETL?
Um gargalo ocorre quando determinado componente limita a velocidade de execução do pipeline, impedindo que os demais recursos sejam utilizados de maneira eficiente.
Os problemas podem estar relacionados à infraestrutura, à implementação das transformações ou aos sistemas de origem e destino.
| Recurso | Possível gargalo | Impacto |
|---|---|---|
| CPU | Processamento insuficiente | Transformações lentas |
| RAM | Memória insuficiente | Paginação, spill em disco e falhas |
| Armazenamento | Baixo throughput ou IOPS | Demora em leituras e escritas |
| Rede | Banda ou latência inadequada | Extração e transferência lentas |
| Banco de destino | Limites de escrita e contenção | Atrasos no carregamento |
Identificar o componente limitante é essencial antes de ampliar os recursos do servidor. Aumentar a quantidade de núcleos, por exemplo, pode não trazer benefícios quando o processo está limitado pela velocidade de leitura de uma API externa.
Como dimensionar a CPU para processamento ETL?
A CPU é responsável por executar transformações, cálculos, validações, compressão e outras operações necessárias ao processamento dos dados.
Workloads com agregações complexas, manipulação de grandes tabelas e execução simultânea de tarefas podem exigir vários núcleos de processamento.
Quando mais núcleos fazem diferença?
O ganho depende da capacidade da ferramenta ETL de distribuir operações entre múltiplas threads ou processos.
Ferramentas como Apache Spark e determinados mecanismos de processamento paralelo conseguem distribuir parte das transformações entre diferentes recursos computacionais.
Entretanto, pipelines sequenciais ou limitados por uma única thread podem se beneficiar mais de processadores com maior desempenho por núcleo.
Por isso, o dimensionamento deve considerar:
- Quantidade de pipelines simultâneos.
- Grau de paralelismo suportado pela aplicação.
- Complexidade das transformações.
- Tempo máximo disponível para execução.
- Utilização de CPU durante os períodos de pico.
Também é importante avaliar a contenção entre processos, evitando que diferentes pipelines concorram excessivamente pelos mesmos recursos.
Qual é a importância da memória RAM no processamento ETL?
A memória RAM influencia diretamente a execução de operações que precisam manter conjuntos de dados temporários durante o processamento.
Transformações que envolvem joins, ordenações, agrupamentos e agregações podem consumir grandes quantidades de memória.
Quando a RAM disponível é insuficiente, o mecanismo de processamento pode utilizar arquivos temporários em disco, aumentando a latência das operações.
Como estimar a memória necessária?
O cálculo deve considerar o volume de dados processado simultaneamente, e não apenas o tamanho total do conjunto de dados.
Os principais fatores incluem:
- Tamanho dos lotes processados.
- Quantidade de tarefas executadas em paralelo.
- Memória utilizada por estruturas intermediárias.
- Overhead da ferramenta ETL.
- Consumo do sistema operacional e de serviços auxiliares.
Considere um pipeline que utiliza oito workers simultâneos, cada um consumindo até 4 GiB de memória durante as transformações.
Somente esses processos podem exigir aproximadamente 32 GiB de RAM. Ainda será necessário reservar capacidade para o sistema operacional, o mecanismo de execução e eventuais picos de consumo.
Como o armazenamento influencia o desempenho do ETL?
O armazenamento é importante principalmente quando os pipelines realizam leituras frequentes, gravações intermediárias e movimentação de grandes volumes de dados.
Mesmo quando as transformações são executadas em memória, determinadas operações podem gerar arquivos temporários, checkpoints e resultados parciais.
Por que utilizar armazenamento NVMe?
Unidades NVMe oferecem baixa latência e capacidade elevada de operações de entrada e saída, sendo relevantes para workloads com acesso intenso ao armazenamento.
Entre as situações que podem se beneficiar estão:
- Leitura de grandes conjuntos de arquivos.
- Criação de arquivos temporários.
- Operações de ordenação que excedem a memória disponível.
- Processamento de dados em lotes.
- Gravação de resultados intermediários.
Entretanto, a utilização de NVMe não elimina gargalos de CPU, memória ou rede. O ganho depende da participação das operações de I/O no tempo total do pipeline.
Também é necessário avaliar a capacidade útil, a durabilidade das unidades e a configuração de redundância adequada à aplicação.
Como evitar gargalos de rede na extração e carga de dados?
Em pipelines que movimentam informações entre diferentes servidores, a conectividade pode determinar a velocidade máxima de extração e carregamento.
Isso acontece especialmente quando os dados são transferidos de bancos remotos, APIs ou sistemas distribuídos.
Quais fatores devem ser avaliados?
- Largura de banda disponível entre origem e destino.
- Latência das conexões.
- Limites de requisições de APIs.
- Capacidade dos bancos de origem e destino.
- Quantidade de transferências simultâneas.
- Volume de dados movimentado em cada execução.
Uma conexão de 1 Gbps, por exemplo, possui capacidade teórica de aproximadamente 125 MB/s, antes de considerar overhead de protocolos e outras limitações.
Transferir 500 GB por essa conexão exigiria, teoricamente, cerca de 67 minutos. O tempo real pode ser maior devido à concorrência, latência e capacidade dos sistemas envolvidos.
Por isso, a infraestrutura deve ser dimensionada considerando o volume de dados e a janela disponível para processamento.
Como otimizar pipelines ETL para reduzir gargalos?
O desempenho do ETL depende tanto da infraestrutura quanto da maneira como os pipelines são implementados.
Algumas estratégias permitem reduzir operações desnecessárias e aproveitar melhor os recursos disponíveis.
Utilize processamento incremental
Em vez de extrair novamente todo o conjunto de dados, o processamento incremental movimenta apenas registros novos ou alterados.
Técnicas como Change Data Capture (CDC) podem reduzir o volume transferido e o tempo de execução, desde que a origem suporte a identificação confiável das alterações.
Divida o processamento em lotes
O processamento em lotes permite controlar a quantidade de registros mantida simultaneamente em memória.
Essa abordagem ajuda a reduzir picos de consumo e facilita a recuperação de tarefas interrompidas.
Ajuste o paralelismo
Executar tarefas simultaneamente pode reduzir o tempo total do pipeline, desde que existam recursos suficientes e os sistemas de origem e destino suportem a concorrência.
Paralelismo excessivo, por outro lado, pode provocar contenção de CPU, saturação de armazenamento e aumento de latência.
Reduza transferências desnecessárias
Filtros, projeção de colunas e transformações executadas próximas à origem podem diminuir o volume de dados movimentado.
Entretanto, é necessário avaliar o impacto dessas operações sobre os sistemas de produção.
Utilize formatos adequados
Formatos colunares como Parquet podem melhorar determinadas cargas analíticas ao permitir compressão e leitura seletiva de colunas.
A escolha deve considerar a compatibilidade das ferramentas e o padrão de consulta ou processamento.
Como dimensionar um servidor dedicado para ETL?
O dimensionamento deve partir de medições reais ou testes representativos, considerando o volume de dados, a complexidade das transformações e a janela disponível para execução.
Uma avaliação inicial pode seguir cinco etapas:
- Mapear as fontes: identificar bancos, APIs, arquivos e demais sistemas envolvidos.
- Medir o volume: calcular os dados extraídos, transformados e carregados em cada execução.
- Identificar os gargalos: acompanhar CPU, RAM, I/O e rede durante os pipelines.
- Testar configurações: comparar diferentes níveis de paralelismo, tamanhos de lote e recursos.
- Planejar crescimento: reservar capacidade para novos fluxos e aumento do volume de dados.
Quais recursos priorizar conforme o workload?
| Perfil de ETL | Recurso prioritário | Ponto de atenção |
|---|---|---|
| Transformações complexas | CPU | Paralelismo e uso por núcleo |
| Joins e agregações extensas | RAM | Spill e estruturas intermediárias |
| Arquivos e dados temporários | NVMe | IOPS, throughput e latência |
| Transferências volumosas | Rede | Banda e limites da origem |
| Pipelines simultâneos | CPU, RAM e I/O | Contenção entre tarefas |
Em aplicações que utilizam ferramentas como Apache Airflow, é importante distinguir os recursos consumidos pelo orquestrador daqueles utilizados pelos processos efetivos de transformação.
O Airflow organiza e executa workflows, mas o processamento pode ocorrer em workers, containers ou sistemas externos. Por isso, a infraestrutura deve ser dimensionada conforme a arquitetura utilizada.
Quais métricas monitorar para identificar gargalos?
O monitoramento deve relacionar o consumo de recursos ao desempenho de cada etapa do pipeline.
Entre os principais indicadores estão:
- Tempo de execução: duração total e por etapa do ETL.
- Throughput: quantidade de registros ou bytes processados por segundo.
- Utilização de CPU: consumo por processo, núcleo e período.
- Consumo de RAM: memória residente, paginação e ocorrências de falta de memória.
- I/O de disco: throughput, IOPS e latência.
- Rede: taxa de transferência, retransmissões e latência.
- Falhas e retries: quantidade de execuções interrompidas ou repetidas.
- Tempo de espera: atrasos em filas, dependências e sistemas externos.
Ferramentas de observabilidade e monitoramento podem reunir essas informações em dashboards e alertas.
Também é importante acompanhar o histórico das execuções para identificar tendências de crescimento e degradação de desempenho.
Quando utilizar um servidor dedicado para processamento ETL?
Um servidor dedicado pode ser indicado quando os pipelines exigem recursos computacionais previsíveis, grande capacidade de memória ou processamento intensivo durante períodos específicos.
Como o hardware é exclusivo, a empresa pode definir a configuração de CPU, RAM, armazenamento e sistema operacional de acordo com as características do workload.
Essa abordagem é especialmente relevante para:
- Processamento recorrente de grandes volumes de dados.
- Execução de pipelines com janelas rígidas.
- Transformações intensivas em CPU e memória.
- Aplicações que exigem armazenamento local de alto desempenho.
- Ambientes com utilização contínua e demanda previsível.
Entretanto, servidores dedicados não eliminam automaticamente limitações de aplicações, consultas ineficientes ou restrições de sistemas externos.
Para obter ganhos consistentes, a escolha do hardware deve acompanhar a otimização dos pipelines e a análise das métricas de execução.
A abordagem da EVEO para processamento ETL em servidores dedicados
Projetos de engenharia de dados precisam de infraestrutura capaz de acompanhar o crescimento das informações e as exigências de processamento das aplicações.
Com os Servidores Dedicados da EVEO, sua empresa pode contratar recursos físicos exclusivos e configurar o ambiente conforme as necessidades dos pipelines ETL.
A solução oferece:
- Processadores dedicados para workloads de processamento de dados.
- Configurações personalizadas de memória RAM.
- Armazenamento SSD e NVMe conforme a configuração contratada.
- Tráfego ilimitado e opções de conectividade de 1 ou 10 Gbps.
- Ambientes bare metal com controle sobre sistema operacional e aplicações.
- Infraestrutura em Data Centers Tier III.
- Suporte técnico 24/7 em português.
- Mensalidade fixa em reais.
O modelo de locação de hardware permite dimensionar a capacidade computacional sem exigir a compra dos equipamentos físicos.
Com recursos exclusivos, sua empresa pode executar pipelines de extração, transformação e carga com maior previsibilidade de capacidade e controle sobre o ambiente.
Dimensione seu servidor dedicado para processamento ETL
Conte com CPU, memória e armazenamento exclusivos para executar pipelines de dados conforme as necessidades da sua operação.
Fale com um especialista da EVEOPerguntas frequentes sobre processamento ETL em servidor dedicado
O que é processamento ETL?
ETL significa Extract, Transform, Load, ou Extração, Transformação e Carga. É um processo utilizado para coletar dados de diferentes fontes, aplicar regras de transformação e carregar as informações em um sistema de destino, como um banco de dados ou data warehouse.
Quais são os principais gargalos em pipelines ETL?
Os principais gargalos estão relacionados à capacidade de CPU, memória RAM, armazenamento e rede. Consultas ineficientes, excesso de paralelismo, limitações de APIs e baixa capacidade de escrita dos sistemas de destino também podem aumentar o tempo de execução.
Quanto de memória RAM é necessário para executar ETL?
A quantidade depende do volume processado simultaneamente, da complexidade das transformações e da quantidade de tarefas paralelas. Operações como joins, agregações e ordenações podem exigir memória adicional para estruturas intermediárias. O dimensionamento deve utilizar medições reais ou testes representativos.
Armazenamento NVMe melhora o desempenho do ETL?
Sim, quando o pipeline depende de operações intensivas de leitura e escrita. Unidades NVMe podem reduzir a latência de arquivos temporários, checkpoints e movimentação de grandes conjuntos de dados. Entretanto, o ganho será limitado se o gargalo principal estiver na CPU, na memória ou na rede.
Como reduzir o tempo de execução de um pipeline ETL?
É possível utilizar processamento incremental, ajustar o paralelismo, reduzir transferências desnecessárias, otimizar consultas e dimensionar os recursos de infraestrutura. O monitoramento por etapa ajuda a identificar quais operações realmente limitam o desempenho.
Quando utilizar um servidor dedicado para ETL?
O servidor dedicado pode ser indicado para pipelines recorrentes, grandes volumes de dados e transformações intensivas que exigem recursos físicos exclusivos. Ele permite configurar CPU, RAM e armazenamento conforme o workload, oferecendo maior previsibilidade de capacidade para operações empresariais.
Sobre o autor
Fabio Stein é CTO da EVEO e atua com tecnologia e infraestrutura para aplicações empresariais, incluindo servidores dedicados, ambientes de nuvem privada e soluções de processamento de alto desempenho.